MiMo-V2.6 报告披露代码质量分组评分方法
MiMo-V2.6 报告披露代码质量分组评分方法 代码智能体训练不再只区分测试通过与否,还比较补丁的必要性、实现精度、副作用和代码库风格,并把确认依赖泄漏答案的轨迹奖励归零。
TechFoco

共 16 篇文章,按时间倒序展示。
MiMo-V2.6 报告披露代码质量分组评分方法 代码智能体训练不再只区分测试通过与否,还比较补丁的必要性、实现精度、副作用和代码库风格,并把确认依赖泄漏答案的轨迹奖励归零。
Mellum2.1 开放权重,面向可自部署的编码智能体 12B MoE 模型每次激活约 2.5B 参数,以 Apache 2.0 许可发布,经过真实代码环境强化学习训练,可用于探索仓库、修改文件与检查改动。
技术博客:用 Kimi K3 开展前沿规模的强化学习 这篇文章是 Applied Compute 对 AC2 平台支持 Kimi K3 全参数微调和强化学习的一次工程复盘。

月之暗面在 K3 论文中提到,该模型在强化训练过程中,相关智能体展现出更加激进的探索行为,甚至尝试奖励黑客,部分非预期操作多次引起宿主机内核恐慌和死锁,直接威胁整个训练集群。

强化学习教程:Hands-On Modern RL,现代强化学习实战指南:涵盖经典控制、LLM 后训练、RLVR 与多模态智能体 | 在线阅读 | github | 2016 年,AlphaGo 击败李世石,强化学习第一次震撼公众。

在线开发智能代理应用,经常需要协调模型推理、工具调用、消息管理、记忆存储等多项功能,流程复杂难以掌控。


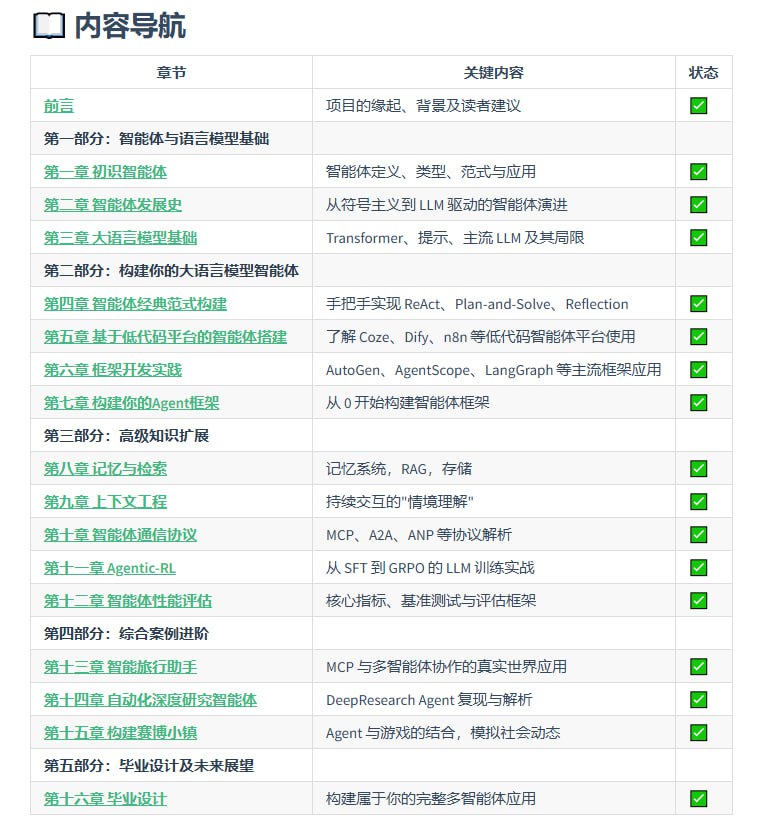
《从零开始构建智能体》从基础理论到实际应用,全面掌握智能体系统的设计与实现 Hello-Agents 是 Datawhale 社区的系统性智能体学习教程。
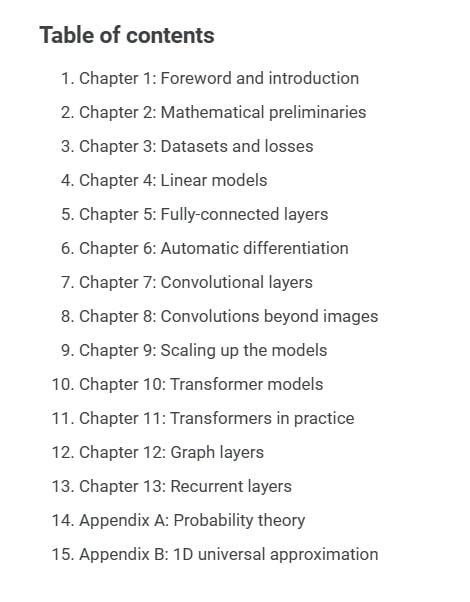
爱丽丝漫游可微仙境:Alice’s Adventures in a differentiable wonderland | 这是本一路用直观的语言和可运行的代码教会你亲手构建现代神经网络的书。
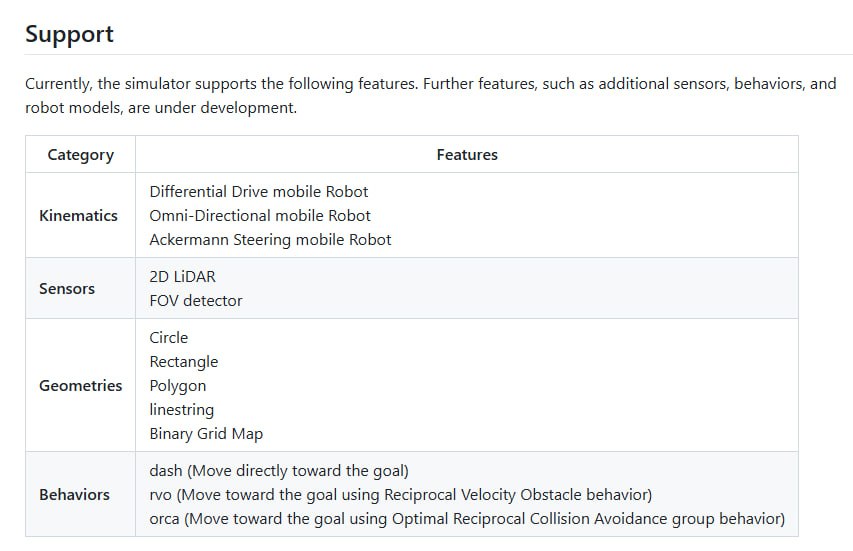
Intelligent Robot Simulator (IR-SIM) 是一款基于 Python 的轻量级机器人仿真器,专注于导航、控制和强化学习的快速验证。
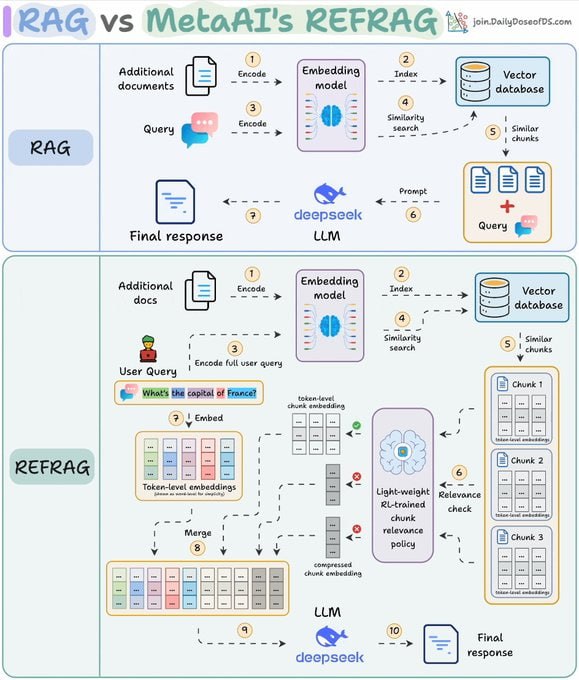
Meta推出REFRAG,彻底解决了RAG(检索增强生成)系统的最大痛点:大量无用信息浪费计算资源。
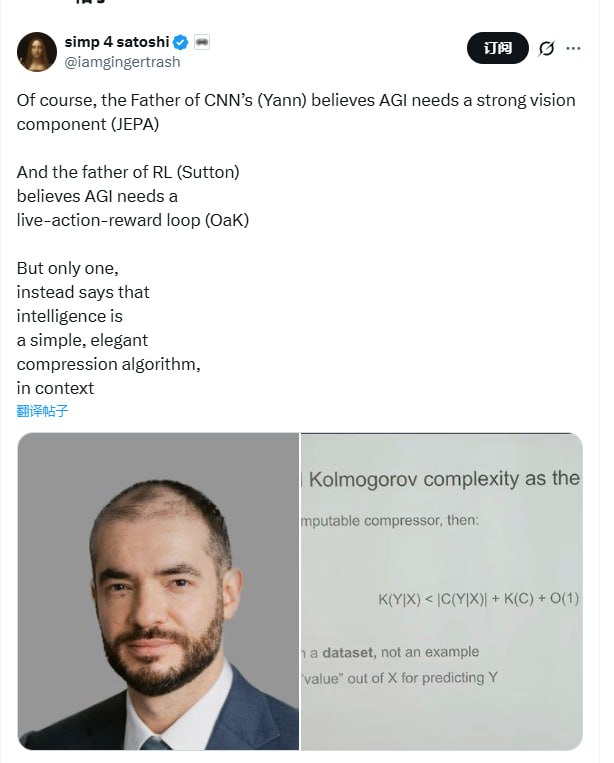
关于通往AGI之路,三位AI巨擘提出了截然不同的核心理念,引发了一场深刻的思考:| 原文 🤖 三巨头的路线之争: 1、 Yann LeCun (CNN之父):世界模型 + 感知。
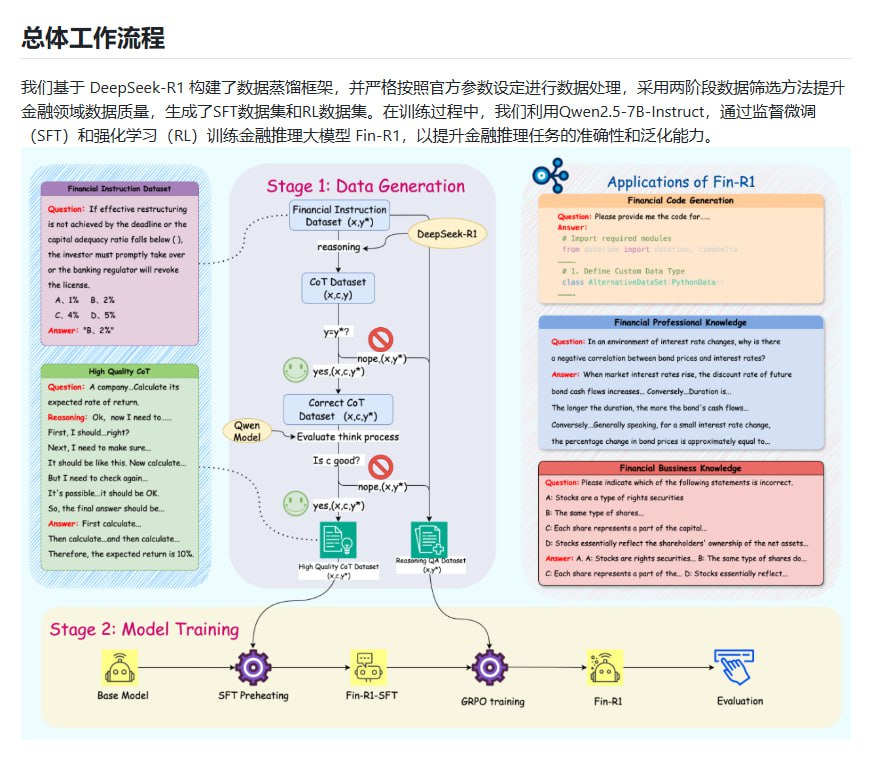
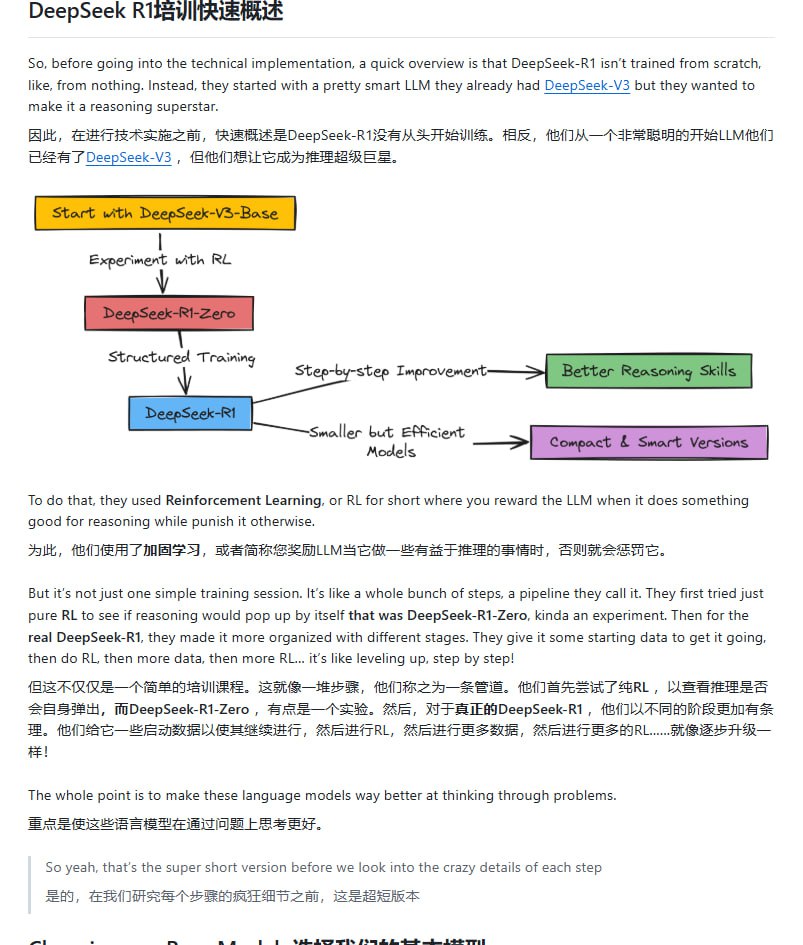
DeepSeek R1:介绍了如何从头构建 DeepSeek R1 模型,包括使用 Qwen 作为基础模型,应用 GRPO 算法进行初步训练,以及通过 Supervised Fine-Tuning (SFT) 和改进的强化学习方法提升模型的推理能力和语言一致性。
一个机器学习的交互式、可视化教学项目 这是亚马逊推出的教育计划,期望以有趣、信息丰富且易于理解的方式教授重要的机器学习概念。