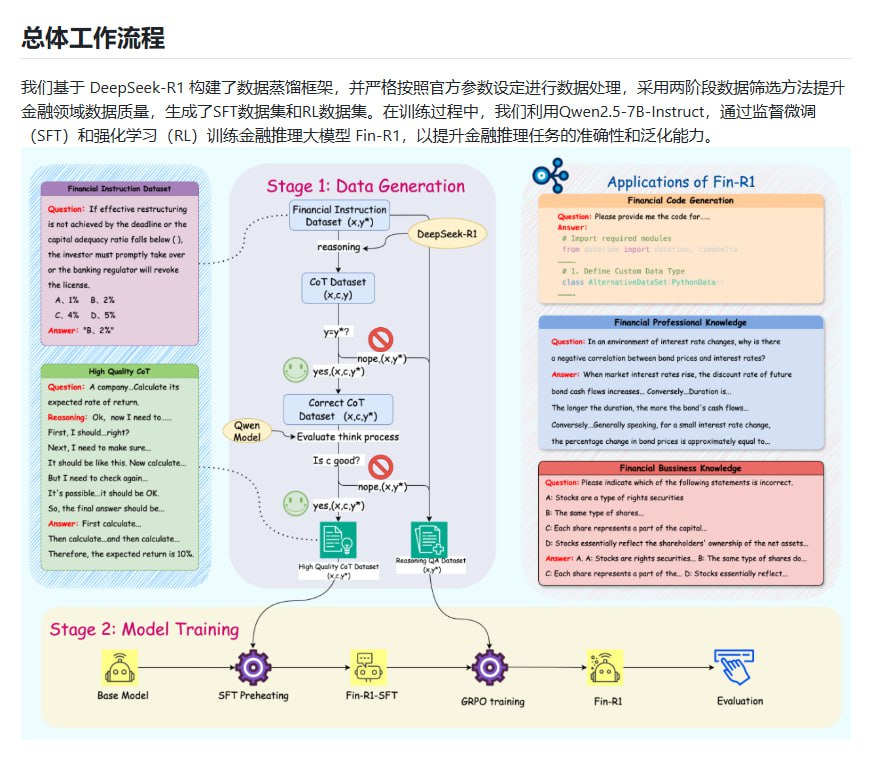
监督微调 专题
共 2 篇文章,按时间倒序展示。
DeepSeek R1:介绍了如何从头构建 DeepSeek R1 模型,包括使用 Qwen 作
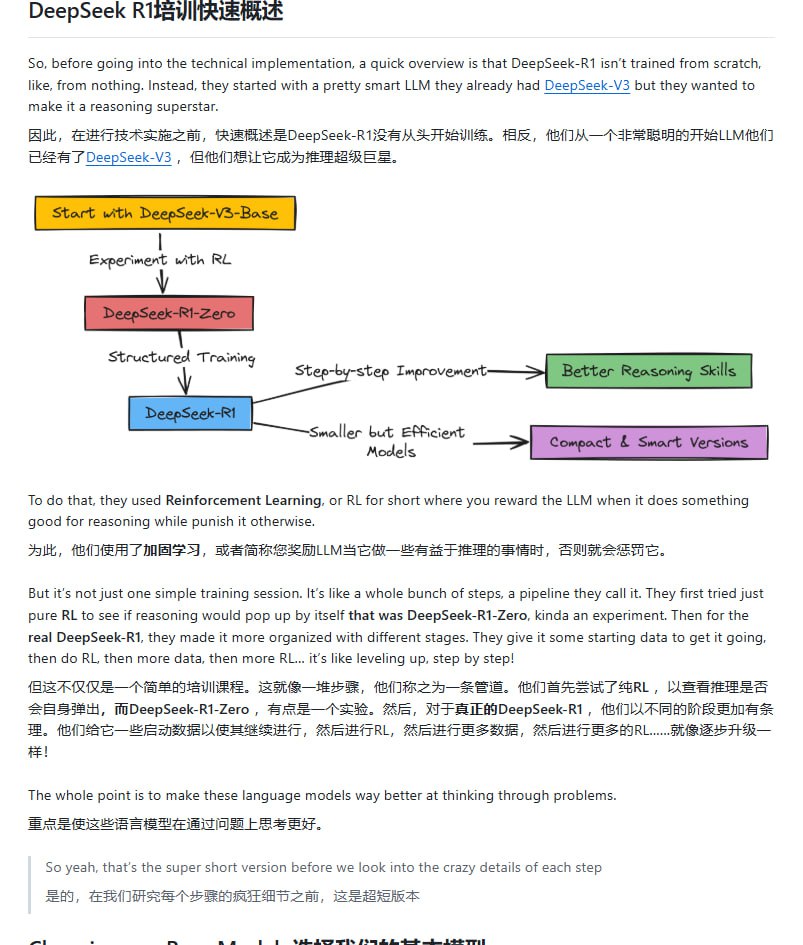
DeepSeek R1:介绍了如何从头构建 DeepSeek R1 模型,包括使用 Qwen 作为基础模型,应用 GRPO 算法进行初步训练,以及通过 Supervised Fine-Tuning (SFT) 和改进的强化学习方法提升模型的推理能力和语言一致性。
TechFoco

共 2 篇文章,按时间倒序展示。
DeepSeek R1:介绍了如何从头构建 DeepSeek R1 模型,包括使用 Qwen 作为基础模型,应用 GRPO 算法进行初步训练,以及通过 Supervised Fine-Tuning (SFT) 和改进的强化学习方法提升模型的推理能力和语言一致性。