【微调全家桶:Liquid AI 的这份食谱把门槛拆了】| github Leonie 分享的这
【微调全家桶:Liquid AI 的这份食谱把门槛拆了】| github Leonie 分享的这份开发者资源把散落各处的微调技术集成到了一起,从传统的 SFT 监督微调到时下热门的 DPO 和 GRPO 强化学习方案,不仅支持文本还覆盖了音视频多模态模型。
TechFoco


共 4 篇文章,按时间倒序展示。
【微调全家桶:Liquid AI 的这份食谱把门槛拆了】| github Leonie 分享的这份开发者资源把散落各处的微调技术集成到了一起,从传统的 SFT 监督微调到时下热门的 DPO 和 GRPO 强化学习方案,不仅支持文本还覆盖了音视频多模态模型。
强化学习教程:Hands-On Modern RL,现代强化学习实战指南:涵盖经典控制、LLM 后训练、RLVR 与多模态智能体 | 在线阅读 | github | 2016 年,AlphaGo 击败李世石,强化学习第一次震撼公众。

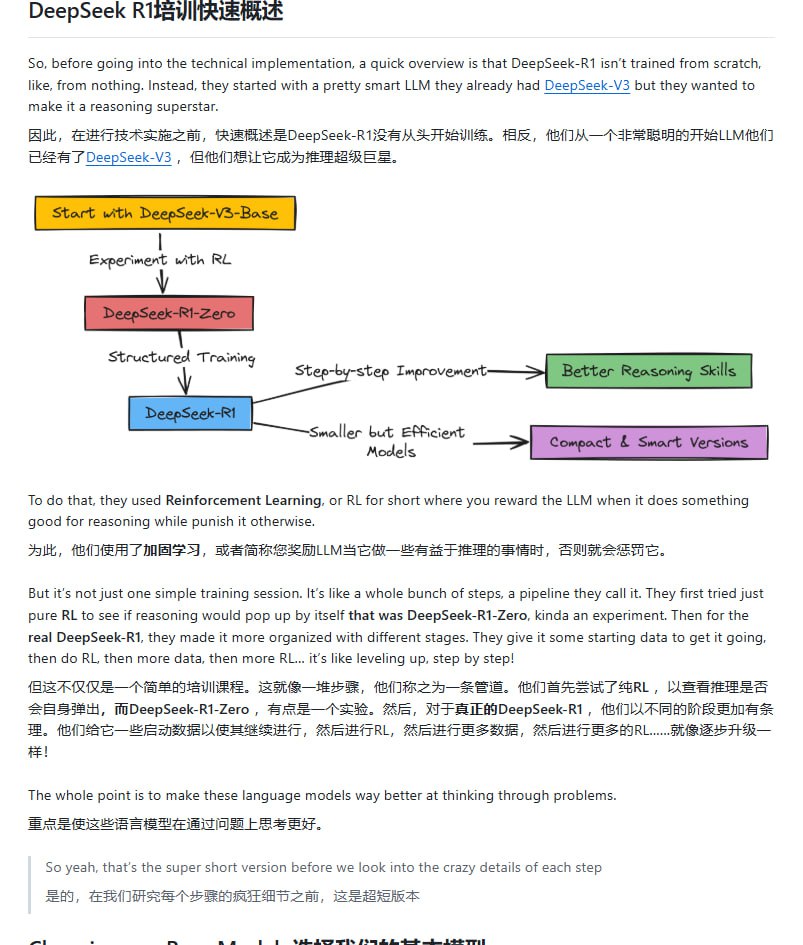
DeepSeek R1:介绍了如何从头构建 DeepSeek R1 模型,包括使用 Qwen 作为基础模型,应用 GRPO 算法进行初步训练,以及通过 Supervised Fine-Tuning (SFT) 和改进的强化学习方法提升模型的推理能力和语言一致性。
Huggingface 这个 Open R1 的文章牛皮啊 整理了 Deepseek R1 发布到现在所有重要内容和社区工作 - 复现对于 R1 的评估分数 - 复现 R1 训练管道,比如 GRPO - 合成数据生成流程,重现类似 R1 的推理数据集 - 市面上所有重要人物对于 R1 模型的表态 - 尝试复现 R1 的开源项目