TechFoco Logo
首页专题归档站点地图
© 2026 TechFoco. All rights reserved.
文章归档专题网站地图站点地图 XML爬虫规则
  1. 首页
  2. /
  3. 返回归档
  4. /
  5. 【微调全家桶:Liquid AI 的这份食谱把门槛拆了】| github Leonie 分享的这

【微调全家桶:Liquid AI 的这份食谱把门槛拆了】| github Leonie 分享的这

2026年08月16日•TechFoco 精选

【微调全家桶:Liquid AI 的这份食谱把门槛拆了】| github Leonie 分享的这份开发者资源把散落各处的微调技术集成到了一起,从传统的 SFT 监督微调到时下热门的 DPO 和 GRPO 强化学习方案,不仅支持文本还覆盖了音视频多模态模型。

【微调全家桶:Liquid AI 的这份食谱把门槛拆了】| github Leonie 分享的这份开发者资源把散落各处的微调技术集成到了一起,从传统的 SFT 监督微调到时下热门的 DPO 和 GRPO 强化学习方案,不仅支持文本还覆盖了音视频多模态模型。

借助 Unsloth 和 TRL 等工具,这份指南实际上为那些想在有限算力下定制垂直领域模型的开发者提供了一套完整的工程方案。

与其说这是一份文档,不如说它解决了开发者最头疼的选型焦虑。

文章配图 1
文章配图 1

社区一针见血地指出,选择微调方法往往比训练本身更耗时,而这份资源让方案对比变得直观。

虽然目前还缺少显存占用和评估基线的量化标注,难以实现完全的横向比对,但对于正在处理小模型或者冷门语种任务的人来说,这依然是一座避开无效实验的宝藏。

它给出的信号很明确:AI 开发正在从玄学调优向标准工程化转变,比起纠结参数,直接上手跑通一套成熟的路径才是正经事。

文章链接

  • 查看原文https://github.com/Liquid4All/cookbook

相关标签

SFTDPOGRPO多模态微调UnslothTRL

继续阅读

较新文章

【药房AI“劝退”潮:当救命的处方撞上不靠谱的智能体】| blog 连锁药房 Kinney Dr

较早文章

【DeepSeek Harness 桌面端:把复杂的 Agent 调度变成开箱即用的软件】 De

相关文章

查看更多
本地大模型+MCP:把AI的“脑子”插上本地插头

本地大模型+MCP:把AI的“脑子”插上本地插头

本地大模型+MCP:把AI的“脑子”插上本地插头 以前玩本地大模型,最尴尬的是它空有一脑子理论,却连你电脑里的一个txt文件都打不开。

2026年06月04日
本地大模型MCP
强化学习教程:Hands-On Modern RL,现代强化学习实战指南:涵盖经典控制、LLM

强化学习教程:Hands-On Modern RL,现代强化学习实战指南:涵盖经典控制、LLM

强化学习教程:Hands-On Modern RL,现代强化学习实战指南:涵盖经典控制、LLM 后训练、RLVR 与多模态智能体 | 在线阅读 | github | 2016 年,AlphaGo 击败李世石,强化学习第一次震撼公众。

2026年05月07日
强化学习RLHF
DeepSeek R1:介绍了如何从头构建 DeepSeek R1 模型,包括使用 Qwen 作

DeepSeek R1:介绍了如何从头构建 DeepSeek R1 模型,包括使用 Qwen 作

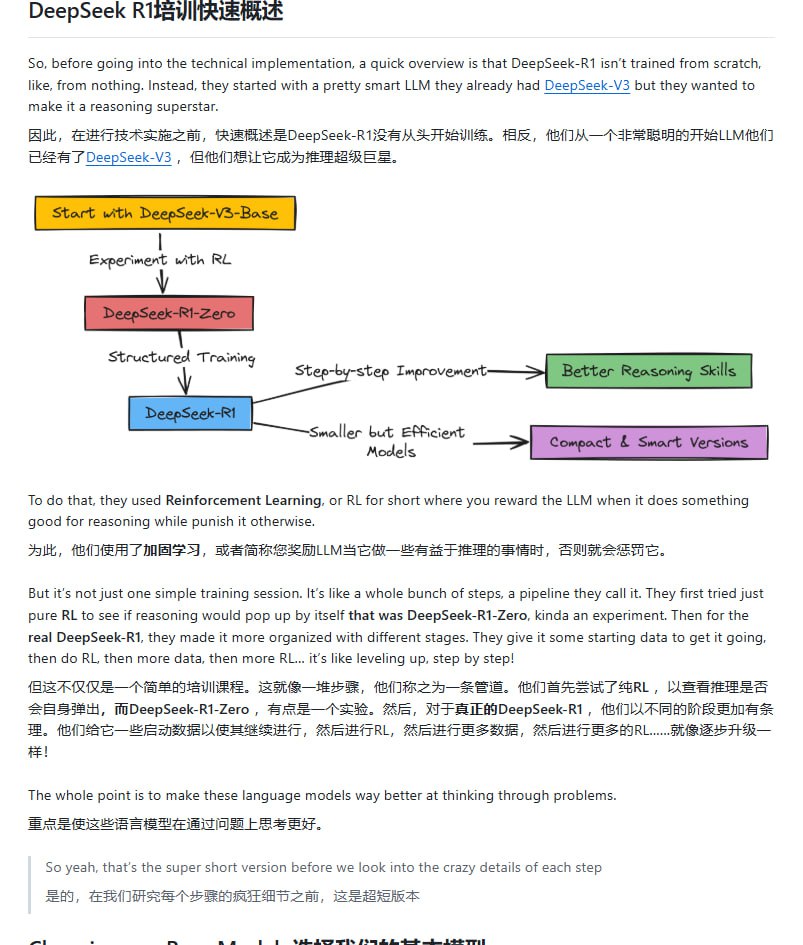
DeepSeek R1:介绍了如何从头构建 DeepSeek R1 模型,包括使用 Qwen 作为基础模型,应用 GRPO 算法进行初步训练,以及通过 Supervised Fine-Tuning (SFT) 和改进的强化学习方法提升模型的推理能力和语言一致性。

2025年02月26日
DeepSeek R1GRPO
Huggingface 这个 Open R1 的文章牛皮啊 整理了 Deepseek R1 发布

Huggingface 这个 Open R1 的文章牛皮啊 整理了 Deepseek R1 发布

Huggingface 这个 Open R1 的文章牛皮啊 整理了 Deepseek R1 发布到现在所有重要内容和社区工作 - 复现对于 R1 的评估分数 - 复现 R1 训练管道,比如 GRPO - 合成数据生成流程,重现类似 R1 的推理数据集 - 市面上所有重要人物对于 R1 模型的表态 - 尝试复现 R1 的开源项目

2025年02月05日
Deepseek R1GRPO