【PromptCache:让 AI 学会“记性”的省钱术】 这是一个 Go 语言编写的开源语义缓
【PromptCache:让 AI 学会“记性”的省钱术】 这是一个 Go 语言编写的开源语义缓存 Proxy,旨在通过识别相似请求来降低大模型调用的成本与延迟。
TechFoco


共 31 篇文章,按时间倒序展示。
【PromptCache:让 AI 学会“记性”的省钱术】 这是一个 Go 语言编写的开源语义缓存 Proxy,旨在通过识别相似请求来降低大模型调用的成本与延迟。
有道在 LobsterAI 之后推出了 Agent 体系下的最新产品——有道宝库,定位为 AI 研究助手与思考伙伴,辅助深度思考与知识内化。
AI Agent开发常常需要管理海量对话历史,传统RAG或知识图谱难以实现真正学习,记忆准确率低、长期遗忘严重。

AI记忆系统突破99%准确率:用Agent完全替代向量数据库 | 推文 Supermemory团队用多智能体协作系统在长期记忆基准测试LongMemEval上达到99%准确率,核心突破是用3个并行搜索Agent替代传统向量检索,让AI通过“理解”而非“数学相似度”来回忆信息。

无限上下文来了,RAG却没死:时效性、可追溯性与成本的三重考验 无限上下文解决的是“装得下”的问题,RAG真正的价值在于知识的时效性、可追溯性和成本控制。
Google 正式发布 Gemini Embedding 2:Google 的首个原生多模态嵌入模型,基于 Gemini 架构构建,首次将文本、图像、视频、音频、文档统一映射到一个共享嵌入空间,彻底打破了以往“文本嵌入独立、图像嵌入独立”的模态壁垒。

在线文档智能检索新利器——OpenRAG 是一款集成Langflow、Docling和OpenSearch的Retrieval-Augmented Generation平台,专为实现智能问答和文档搜索设计。

Prompt Engineering没死,只是换了一张脸 | 帖子 2024年那套靠“魔法短语”驱动AI的玩法基本过时了,但“Prompt Engineering已死”这个论断本身也夸张了——真正死掉的是技巧,活下来的是思维方式,只是迁移到了更高的层面。

OpenViking:字跳开源的一个为 AI Agent 而生的上下文数据库 Agent 开发面临的挑战 在 AI 时代,数据易得,但高质量的上下文却难求。

NotebookLM:被严重低估的AI学习神器 | 文档 谷歌最近为NotebookLM推出了一个官方入门笔记本,用户可以直接在对话中询问“如何用NotebookLM帮我完成某个项目”,获得针对性的使用指导。


学习新知识时常常需要在多个工具间来回切换,看论文用一个软件,做笔记用另一个,遇到问题还得单独搜索,效率很低。
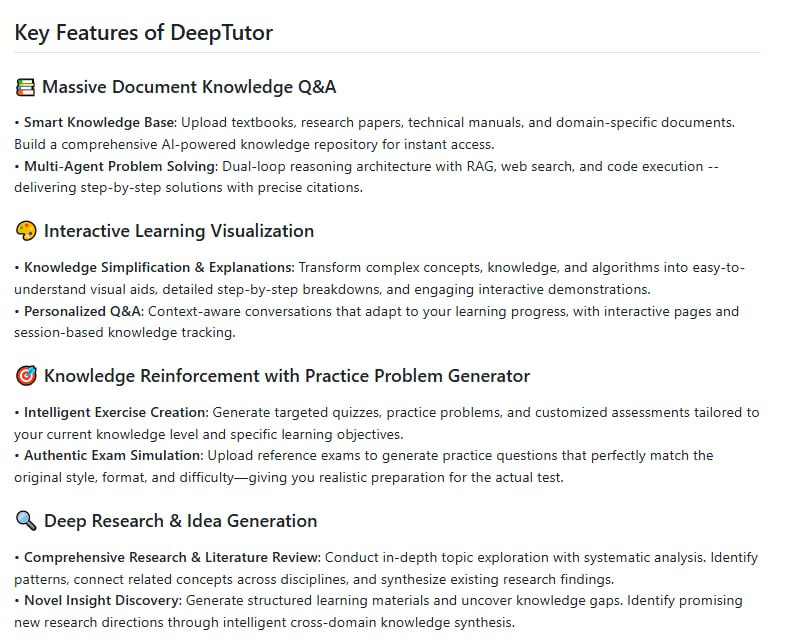
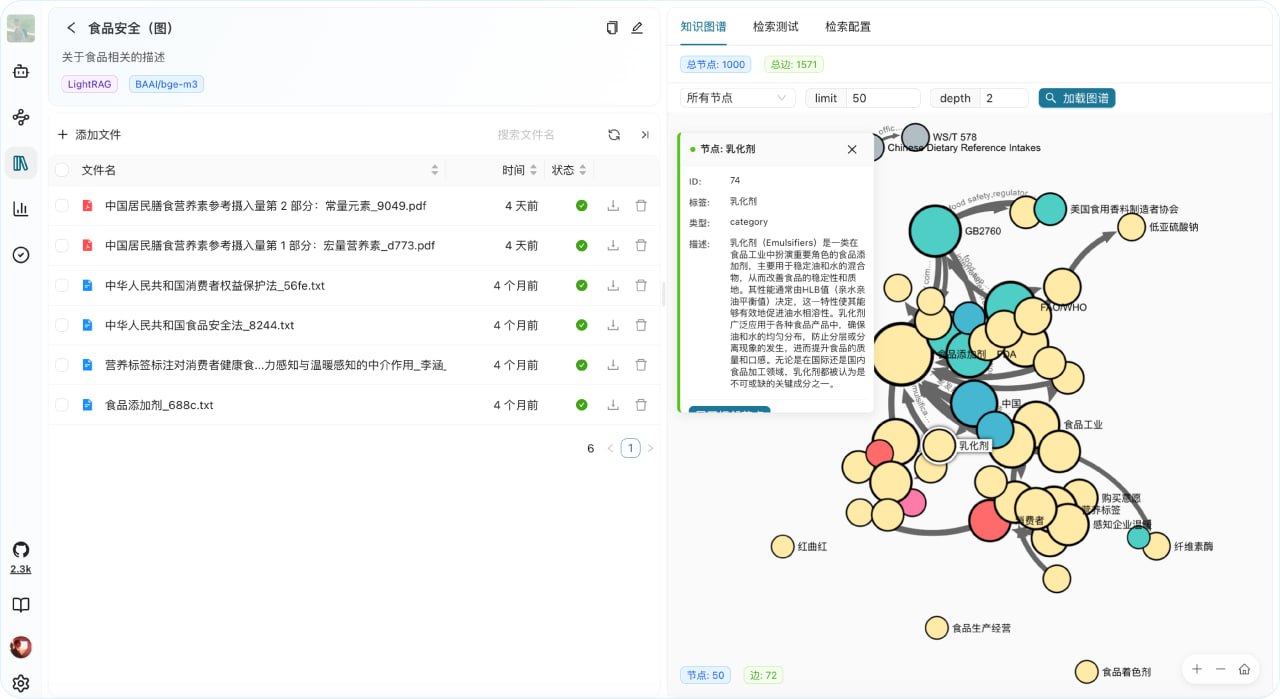
Yuxi-Know是一个基于LightRAG(一个最近比较流行的RAG平台) 构建的RAG知识库和知识图谱平台。
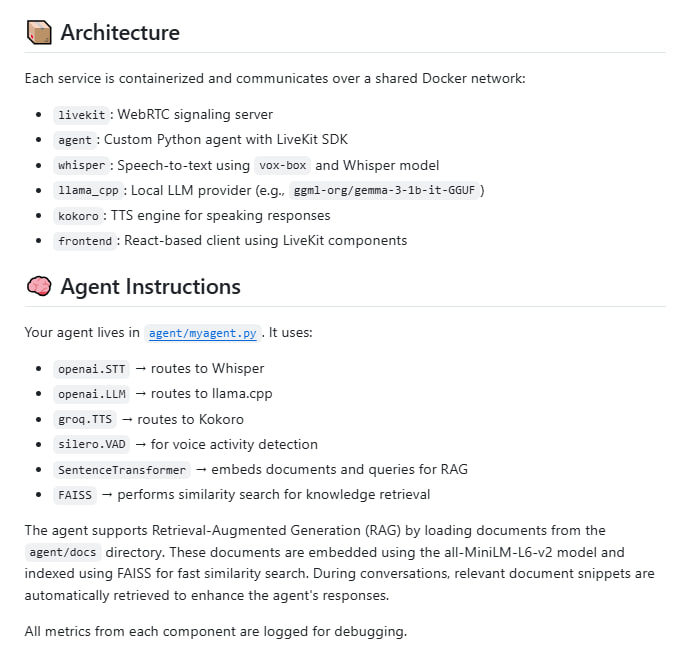
构建一个低延迟的本地语音助手通常需要配置多个独立的模型和服务,从语音识别到大模型推理再到语音合成,复杂的集成过程往往令人望而却步。
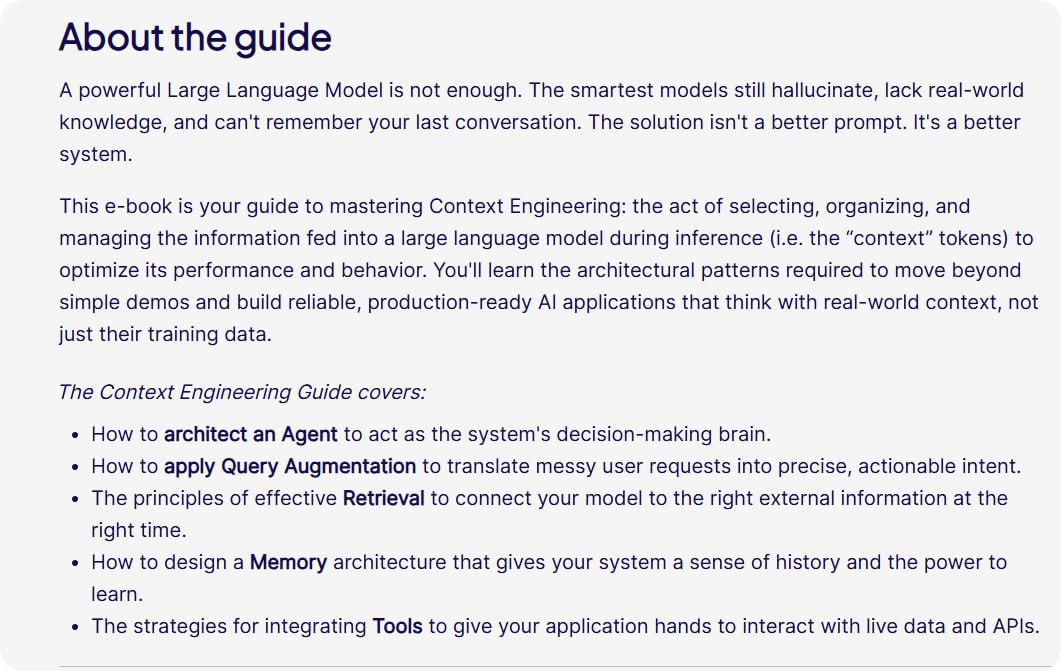
《The Context Engineering Guide》 Context Engineering(上下文工程)远非简单往提示词里堆数据,而是设计智能系统,在恰当时间、用合适格式,动态提供精准信息。
Gemini API新推出File Search工具:一个全托管的检索增强生成(RAG)系统,极大简化了基于数据的智能问答开发流程。
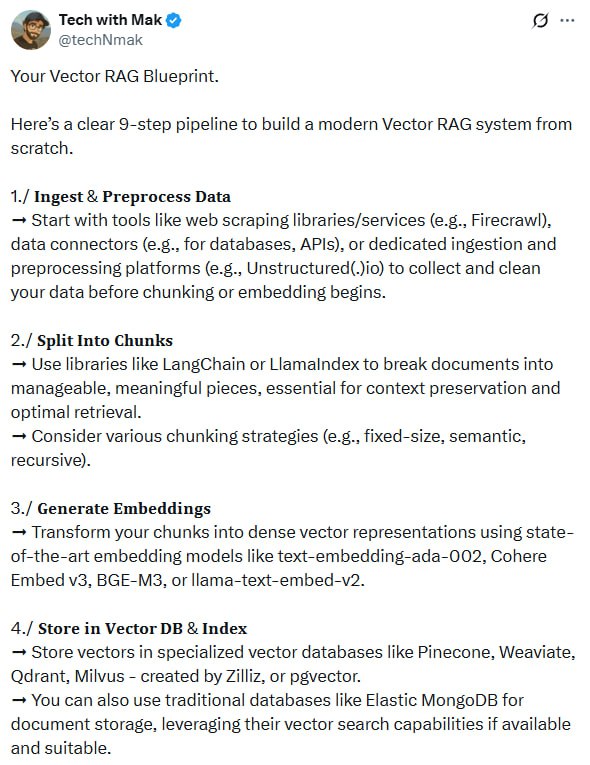
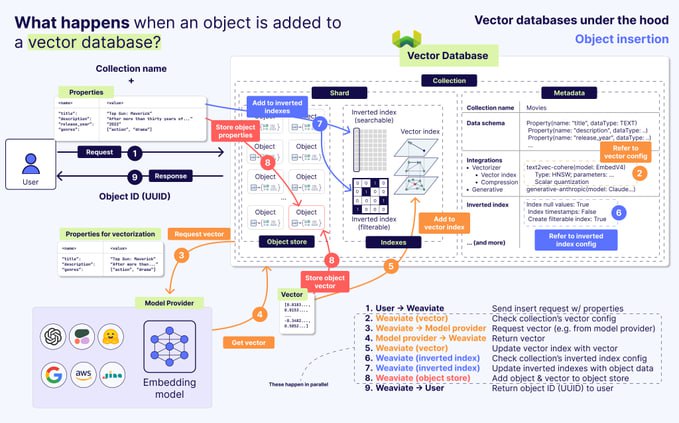
Vector RAG系统构建流程 1. 数据采集与预处理 用爬虫(如Firecrawl)、数据连接器(数据库、API)或专门的平台(如Unstructured.io)收集并清洗数据,确保后续切片和向量化质量。