TechFoco Logo
首页专题归档站点地图
© 2026 TechFoco. All rights reserved.
文章归档专题网站地图站点地图 XML爬虫规则
  1. 首页
  2. /
  3. 返回归档
  4. /
  5. 构建一个低延迟的本地语音助手通常需要配置多个独立的模型和服务,从语音识别到大模型推理再到语音合成

构建一个低延迟的本地语音助手通常需要配置多个独立的模型和服务,从语音识别到大模型推理再到语音合成

2025年12月27日•TechFoco 精选

构建一个低延迟的本地语音助手通常需要配置多个独立的模型和服务,从语音识别到大模型推理再到语音合成,复杂的集成过程往往令人望而却步。

构建一个低延迟的本地语音助手通常需要配置多个独立的模型和服务,从语音识别到大模型推理再到语音合成,复杂的集成过程往往令人望而却步。

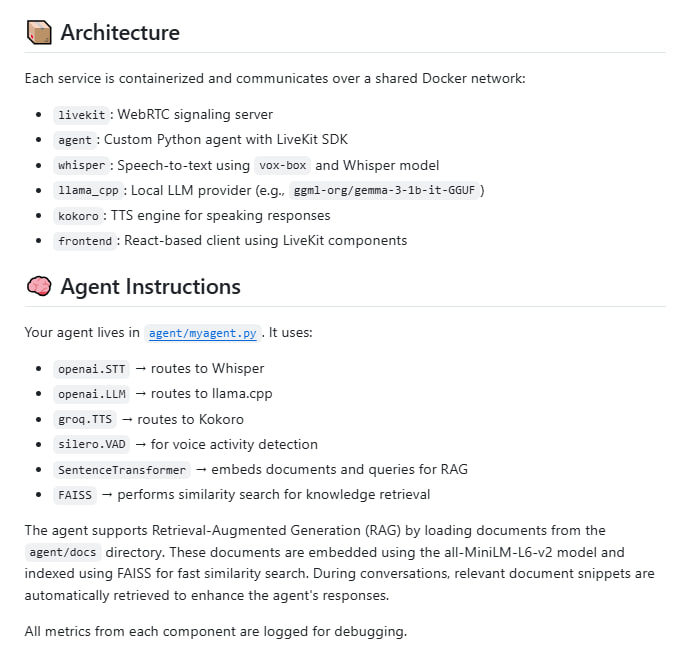
Local Voice AI 是一个全栈开源项目,通过 Docker 容器化技术,将语音交互所需的各个环节深度整合,提供了一套完整的本地化语音助手解决方案。
文章配图 1
文章配图 1

它不仅实现了流畅的实时语音对话,还集成了 RAG 知识库检索功能,让 AI 能够基于本地文档进行精准回复,整个处理过程完全在本地运行,无需依赖外部云服务。

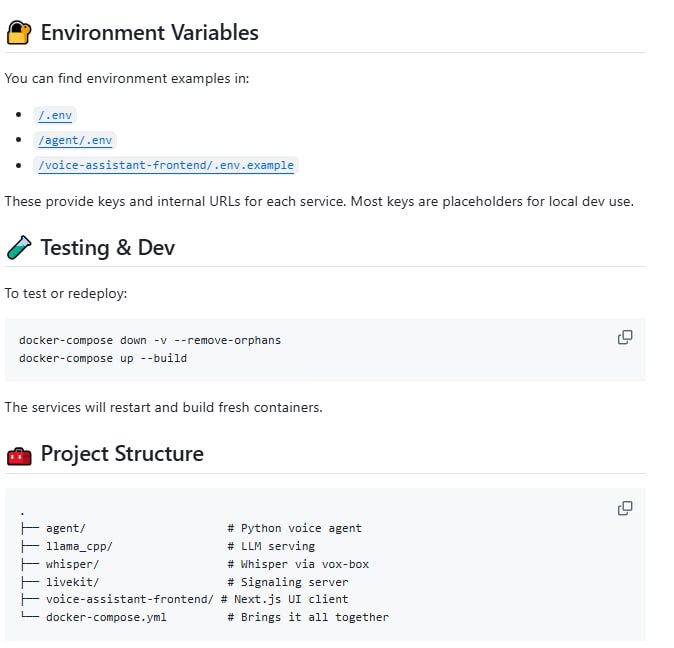
主要功能: - 完整的全栈语音交互链路,涵盖从音频采集到智能响应的全过程; - 集成 Whisper 模型,提供高准确度的实时语音转文字服务; - 采用 Kokoro 引擎进行语音合成,输出自然且高质量的语音反馈; - 内置 RAG 架构,利用 FAISS 和 Sentence Transformers 实现本地文档的检索增强; - 提供基于 Next.js 和 Tailwind 开发的 Web 交互界面,支持实时状态显示; - 模块化容器设计,通过 Docker Compose 即可实现一键式环境搭建与运行。
文章配图 2
文章配图 2

该项目对硬件要求友好,支持在 CPU 环境下运行,建议配备 12GB 以上内存,非常适合对隐私保护有严格要求或希望探索本地 AI 应用的开发者参考使用。

文章链接

  • 查看原文https://github.com/ShayneP/local-voice-ai

相关标签

语音助手本地AIDockerRAG语音识别

继续阅读

较新文章

开发者在调用不同 AI 模型时,常面临账号管理繁琐、API 协议不统一以及配额限制等问题,在不同

较早文章

为 AI 智能体集成网页操作能力时,经常会遇到目标网站没有公开 API、接口文档极其复杂或者调用

相关文章

查看更多

Foresight 在 Mac 本地整理会议与项目上下文 实验性 Google AI Edge

Foresight 在 Mac 本地整理会议与项目上下文 实验性 Google AI Edge Foresight 已提供 macOS 下载,结合 EmbeddingGemma 2 与 Gemma 4,在本地处理会议音频、补全简写笔记并检索项目资料,可离线运行。

2026年10月07日
Google AI EdgeForesight

AIHOT 开源可自部署的内容筛选与聚合框架 框架公开采集、独立双次评分、事件去重聚簇和中文摘要

AIHOT 开源可自部署的内容筛选与聚合框架 框架公开采集、独立双次评分、事件去重聚簇和中文摘要流程,提供 Docker 部署以及 RSS、API、MCP 等读取接口。

2026年10月03日
内容聚合开源框架
谷歌发布 Gemini 3.5 Transcribe 语音转文本模型

谷歌发布 Gemini 3.5 Transcribe 语音转文本模型

谷歌发布 Gemini 3.5 Transcribe 语音转文本模型,重点提升实时转写准确率、降低延迟和提高多语言能力等。

2026年08月27日
人工智能语音识别
【药房AI“劝退”潮:当救命的处方撞上不靠谱的智能体】| blog 连锁药房 Kinney Dr

【药房AI“劝退”潮:当救命的处方撞上不靠谱的智能体】| blog 连锁药房 Kinney Dr

【药房AI“劝退”潮:当救命的处方撞上不靠谱的智能体】| blog 连锁药房 Kinney Drugs 近期紧急下线了其 AI 助手 Burt,原因是该系统在处理处方药时表现糟糕:语音混乱、甚至搞错药剂数量。

2026年08月16日
LLM语音助手
【PromptCache:让 AI 学会“记性”的省钱术】 这是一个 Go 语言编写的开源语义缓

【PromptCache:让 AI 学会“记性”的省钱术】 这是一个 Go 语言编写的开源语义缓

【PromptCache:让 AI 学会“记性”的省钱术】 这是一个 Go 语言编写的开源语义缓存 Proxy,旨在通过识别相似请求来降低大模型调用的成本与延迟。

2026年08月14日
semantic-cacheLLM
🤖 Qwen 发布 Audio-3.0-ASR-Flash,医学术语识别率超 95% Qwen

🤖 Qwen 发布 Audio-3.0-ASR-Flash,医学术语识别率超 95% Qwen

🤖 Qwen 发布 Audio-3.0-ASR-Flash,医学术语识别率超 95% Qwen 于 7 月 31 日发布新一代语音识别模型 Qwen-Audio-3.0-ASR-Flash,主打上下文一致性、领域术语识别、自定义热词,以及将语音润色输出为结构化文本等能力。

2026年08月01日
语音识别ASR