一张图看懂40个开源大模型:2024-2026年,LLM架构正在收敛还是分裂 | blog Se
一张图看懂40个开源大模型:2024-2026年,LLM架构正在收敛还是分裂 | blog Sebastian Raschka整理了从2024年初到2026年春天发布的40多个开源大模型的架构图谱。
TechFoco


共 6 篇文章,按时间倒序展示。
一张图看懂40个开源大模型:2024-2026年,LLM架构正在收敛还是分裂 | blog Sebastian Raschka整理了从2024年初到2026年春天发布的40多个开源大模型的架构图谱。
让AI模型又快又准的秘密:谷歌Sequential Attention技术解析 | blog 谷歌研究院最近公布了一项名为Sequential Attention的技术,目标直指AI领域的核心难题:如何在不牺牲准确性的前提下,让模型变得更精简、更高效。


Google Research 最新研究揭示了一个简单到令人意外的技巧:在不启用推理模式时,把你的提示词原封不动重复一遍,大模型的表现就能显著提升。

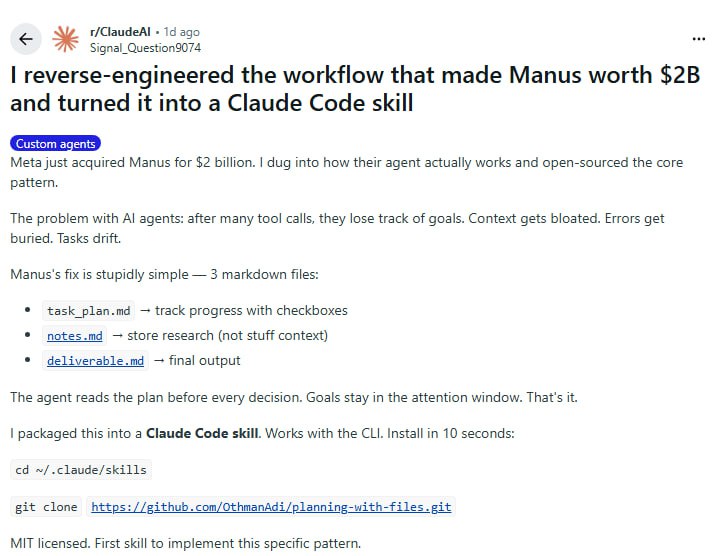
价值20亿美元的AI Agent秘密:三个Markdown文件如何解决上下文漂移难题 Meta刚以20亿美元收购了Manus。
Large Language Model Optimization: Memory, Compute, and Inference Techniques 大型语言模型(LLM)训练与推理的优化技术总结: 随着模型参数规模达到数十亿,传统训练和部署方法面临巨大挑战。