TechFoco Logo
首页专题归档站点地图
© 2026 TechFoco. All rights reserved.
文章归档专题网站地图站点地图 XML爬虫规则
  1. 首页
  2. /
  3. 返回归档
  4. /
  5. 曾发布经典 AI Agent 指南的谷歌高级总监再次出手,带来一份长达 171 页的 LLM 白

曾发布经典 AI Agent 指南的谷歌高级总监再次出手,带来一份长达 171 页的 LLM 白

2025年09月13日•TechFoco 精选

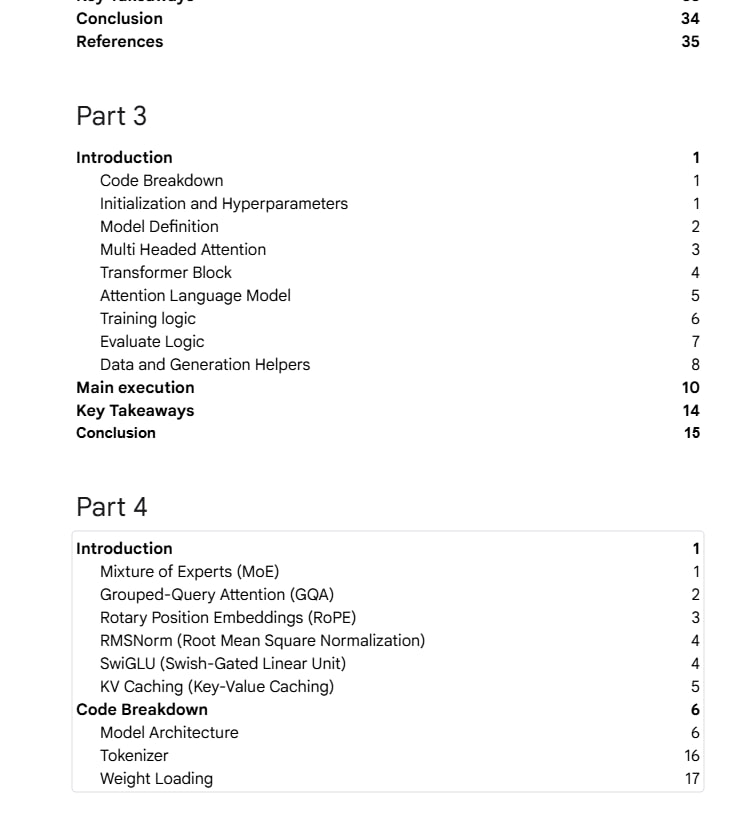
曾发布经典 AI Agent 指南的谷歌高级总监再次出手,带来一份长达 171 页的 LLM 白皮书,堪称目前最全面、最系统化的 LLM 学习文档。
文章配图 1
文章配图 1

文章配图 2
文章配图 2

曾发布经典 AI Agent 指南的谷歌高级总监再次出手,带来一份长达 171 页的 LLM 白皮书,堪称目前最全面、最系统化的 LLM 学习文档。
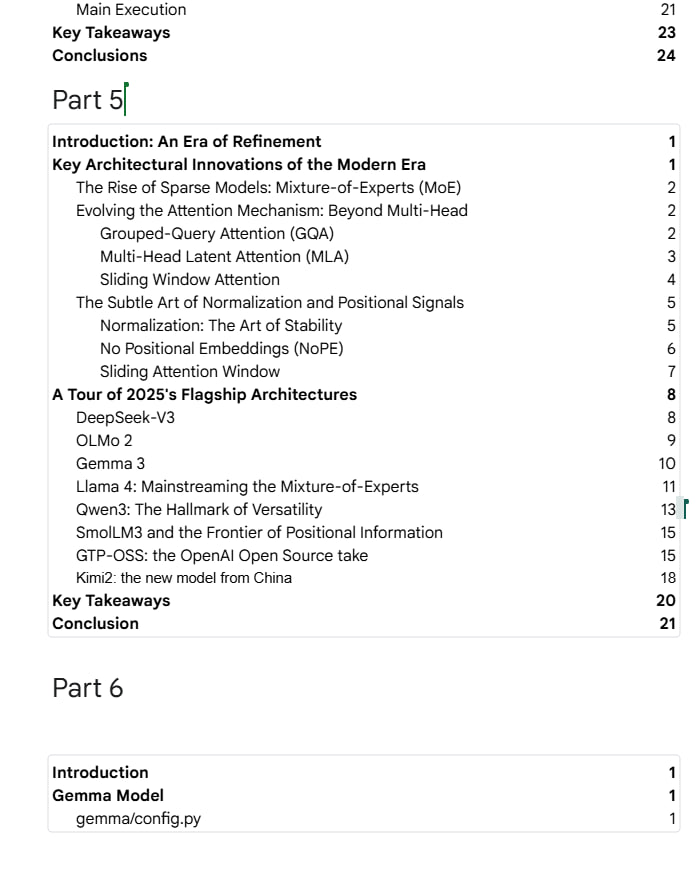
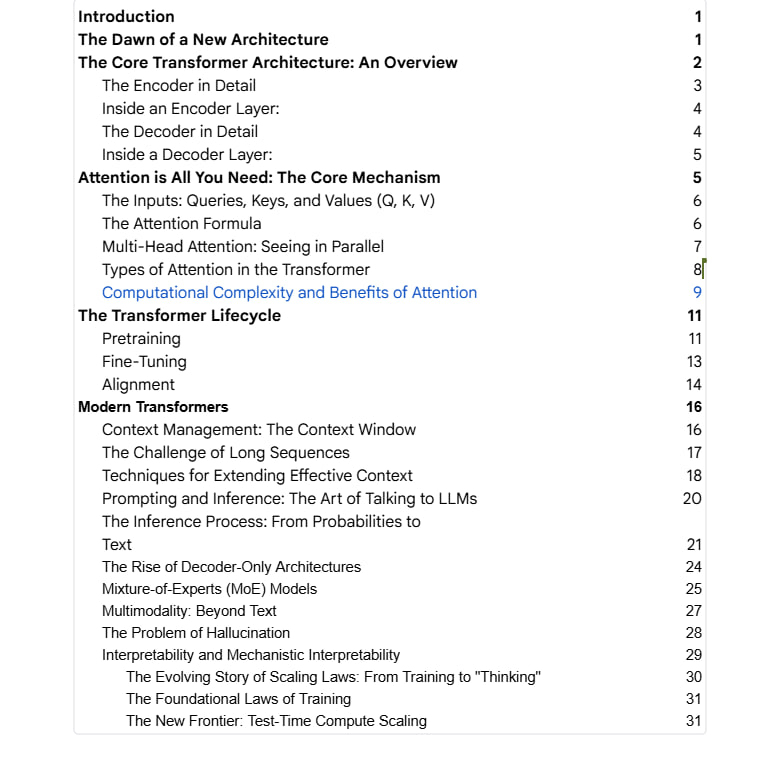
这份文档不仅是知识的集合,更是一张从核心原理到前沿架构的完整技术地图,覆盖了 LLM 领域的几乎所有关键节点。

文档核心结构: - Part 1: 基础原理 🏗 从 Transformer 的开山之作“Attention is All You Need”讲起,深入浅出地剖析了 Encoder/Decoder、多头注意力机制、Scaling Laws 等基础,并延伸至上下文窗口管理、MoE、多模态等现代架构的核心概念。
文章配图 1
文章配图 1

  • Part 2: 推理与对齐 🤖 系统梳理了从思维链 (CoT) 到思维树 (ToT) 的高级推理范式演进,并详细拆解了 RLHF、RLAIF、DPO 等关键的对齐技术,解释了模型如何学会“思考”并与人类价值观对齐。

  • Part 3 & 4: 核心技术与代码实现 🛠 不仅逐行拆解了基础 Transformer 的代码实现,还对 MoE、GQA (Grouped-Query Attention)、RoPE (Rotary Position Embeddings)、KV Caching 等现代 LLM 赖以成功的关键优化技术,进行了原理与代码的双重解读。

文章配图 2
文章配图 2

  • Part 5 & 6: 前沿架构与源码剖析 🔍 全面评述了 2025 年各大厂商的旗舰模型架构,包括 DeepSeek-V3、Llama 4、Gemma 3、Qwen3 等,并以 Google 开源的 Gemma 3 为例,进行了源码级的深度剖析。

这不仅是一份文档,更是一位资深从业者为你精心绘制的 LLM 技术全景图。

文章链接

  • 查看原文https://docs.google.com/document/d/1WUk_A3LDvRJ8ZNvRG--vhI287nDMR-VNM4YOV8mctbI/edit

相关标签

LLMTransformerAttention MechanismRLHFMoECode Implementation

继续阅读

较新文章

Agent Tools:打造可与多系统和API交互的AI agent工具框架,助力实现复杂任务自

较早文章

Speech Note:Linux 及 Sailfish OS 下的全离线语音笔记解决方案,集成

相关文章

查看更多

GPT-6.1 Sol 在 Codex 与 Work 默认扩容至 500k

GPT-6.1 Sol 在 Codex 与 Work 默认扩容至 500k 默认上下文从 272k 提高到 500k,面向需要长期保留仓库信息和任务细节的工作,减少上下文压缩。

2026年10月12日
LLMcontext_window

Mellum2.1 开放权重,面向可自部署的编码智能体

Mellum2.1 开放权重,面向可自部署的编码智能体 12B MoE 模型每次激活约 2.5B 参数,以 Apache 2.0 许可发布,经过真实代码环境强化学习训练,可用于探索仓库、修改文件与检查改动。

2026年10月10日
开放权重MoE

Antigravity 新增 Claude 5.5,并公布旧模型移除时间 官方模型矩阵现列出 C

Antigravity 新增 Claude 5.5,并公布旧模型移除时间 官方模型矩阵现列出 Claude Opus 5.5 与 Sonnet 5.5 的 thinking 版本,面向非试用 Google AI Pro 和 Ultra,免费、Plus 与 Enterprise 不在该次开放范围。

2026年10月06日
Antigravity
Claude 5.5

Kolibri 开放 78B MoE 权重与 vLLM 部署插件

Kolibri 开放 78B MoE 权重与 vLLM 部署插件 Kolibri 发布完整权重并采用 Apache 2.0 许可,拥有 78B 总参数、约 3B 激活参数,支持推理和工具调用。

2026年10月06日
MoEApache-2.0

Naive-N0.5-Flash 开放编码模型与推理实现 面向编码和 AI 研发的模型采用 30

Naive-N0.5-Flash 开放编码模型与推理实现 面向编码和 AI 研发的模型采用 309B MoE、15.5B 激活参数,原生支持百万 token 上下文,权重和推理代码以 MIT 许可开放。

2026年10月03日
MoE大语言模型
【Gemini 3.7 Flash:在“快”与“贵”的夹缝中寻找生态位】 谷歌在 3.6 Fla

【Gemini 3.7 Flash:在“快”与“贵”的夹缝中寻找生态位】 谷歌在 3.6 Fla

【Gemini 3.7 Flash:在“快”与“贵”的夹缝中寻找生态位】 谷歌在 3.6 Flash 发布仅三周后便祭出 3.7 版本,核心卖点是针对 Agent 和编程场景的推理增强,并伴随一个极具迷惑性的“试用价”:价格减半至每百万输入 Token 0.75 美元,但该优惠将于 2026 年底到期。

2026年08月16日
GeminiLLM