谷歌发布 Gemini 3.5 Transcribe 语音转文本模型
谷歌发布 Gemini 3.5 Transcribe 语音转文本模型,重点提升实时转写准确率、降低延迟和提高多语言能力等。
TechFoco


共 9 篇文章,按时间倒序展示。
谷歌发布 Gemini 3.5 Transcribe 语音转文本模型,重点提升实时转写准确率、降低延迟和提高多语言能力等。
🤖 Qwen 发布 Audio-3.0-ASR-Flash,医学术语识别率超 95% Qwen 于 7 月 31 日发布新一代语音识别模型 Qwen-Audio-3.0-ASR-Flash,主打上下文一致性、领域术语识别、自定义热词,以及将语音润色输出为结构化文本等能力。


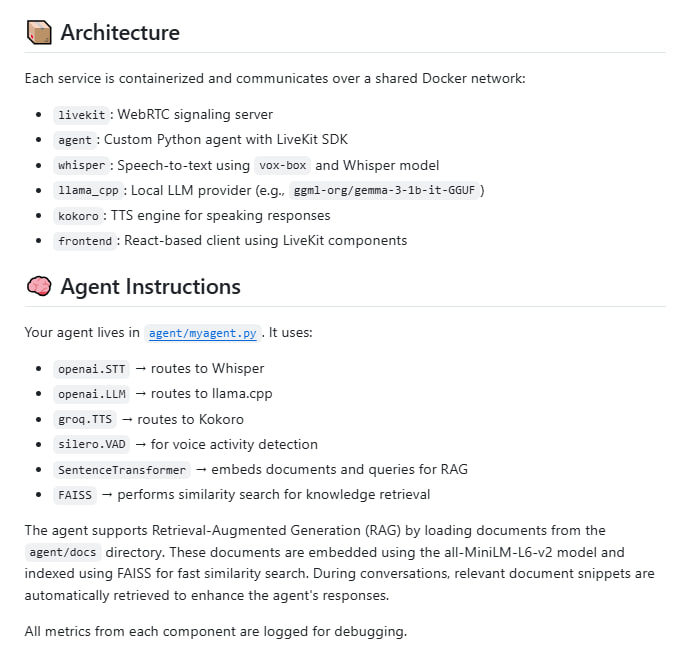
构建一个低延迟的本地语音助手通常需要配置多个独立的模型和服务,从语音识别到大模型推理再到语音合成,复杂的集成过程往往令人望而却步。
ElevenLabs最新推出的Scribe v2 Realtime,是迄今最精准的实时语音转文字模型。
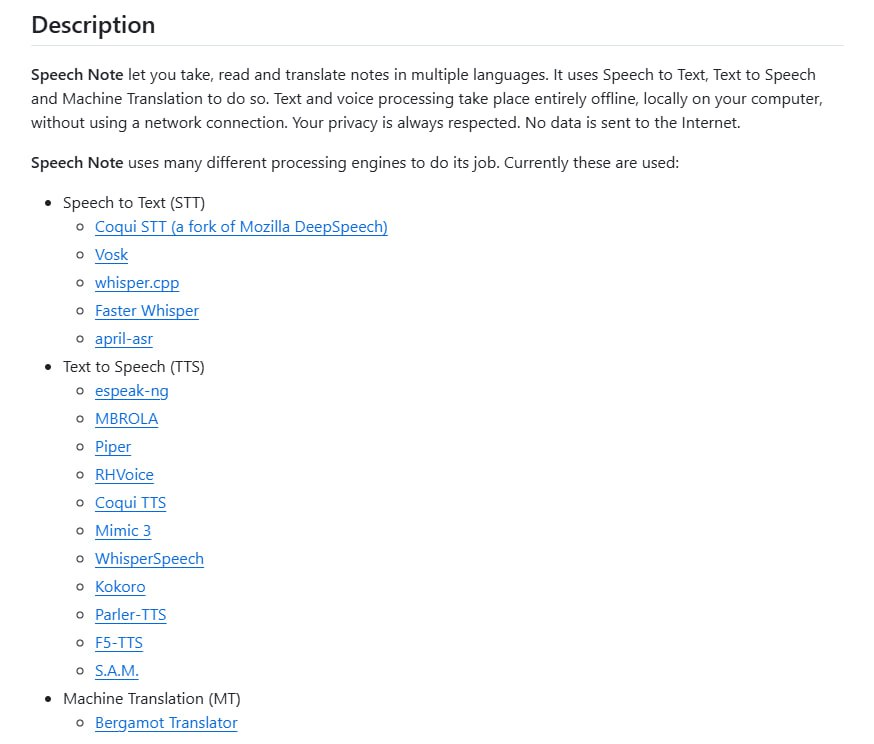
Speech Note:Linux 及 Sailfish OS 下的全离线语音笔记解决方案,集成语音转文字、文字转语音与机器翻译,全面兼顾隐私与多语种支持。
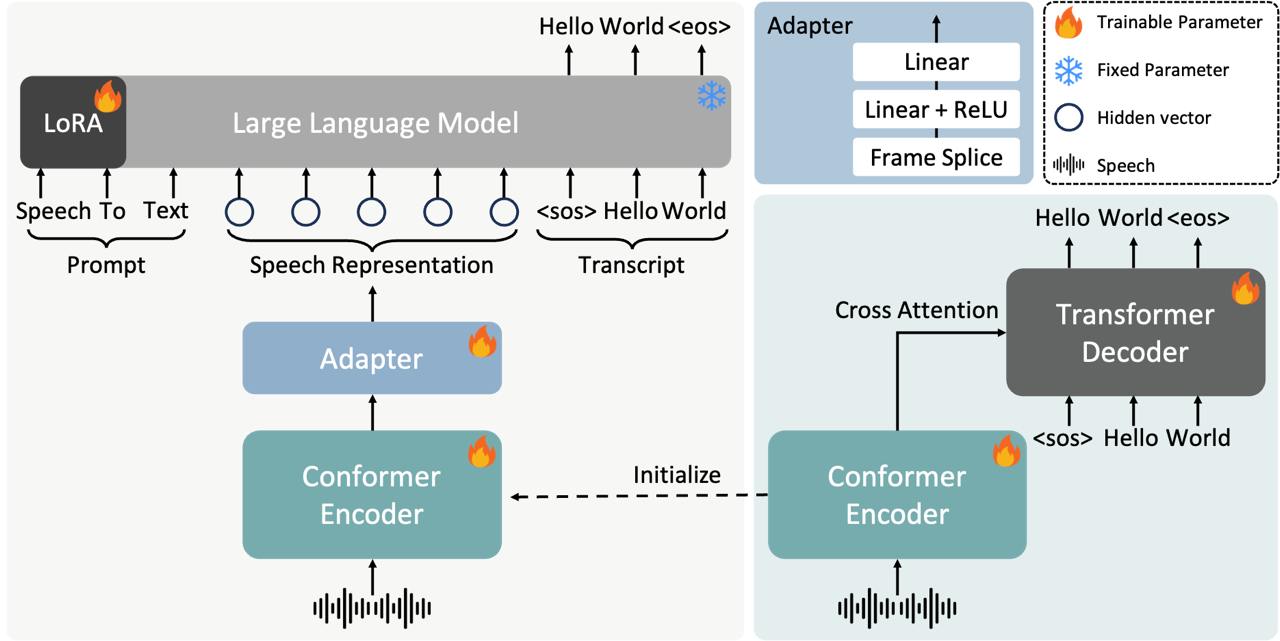
小红书开源了其最新语音识别模型:FireRedASR,擅长识别中英文、方言/歌词,在公共普通话ASR基准测试中达到了新的最佳水平 两种架构设计,LLM版,8.3B参数,高识别准确率,支持无缝的端到端语音交互,适合高质量语音转写 AED版, 1.1B参数,可以平衡性能和效率,适合普通应用场景
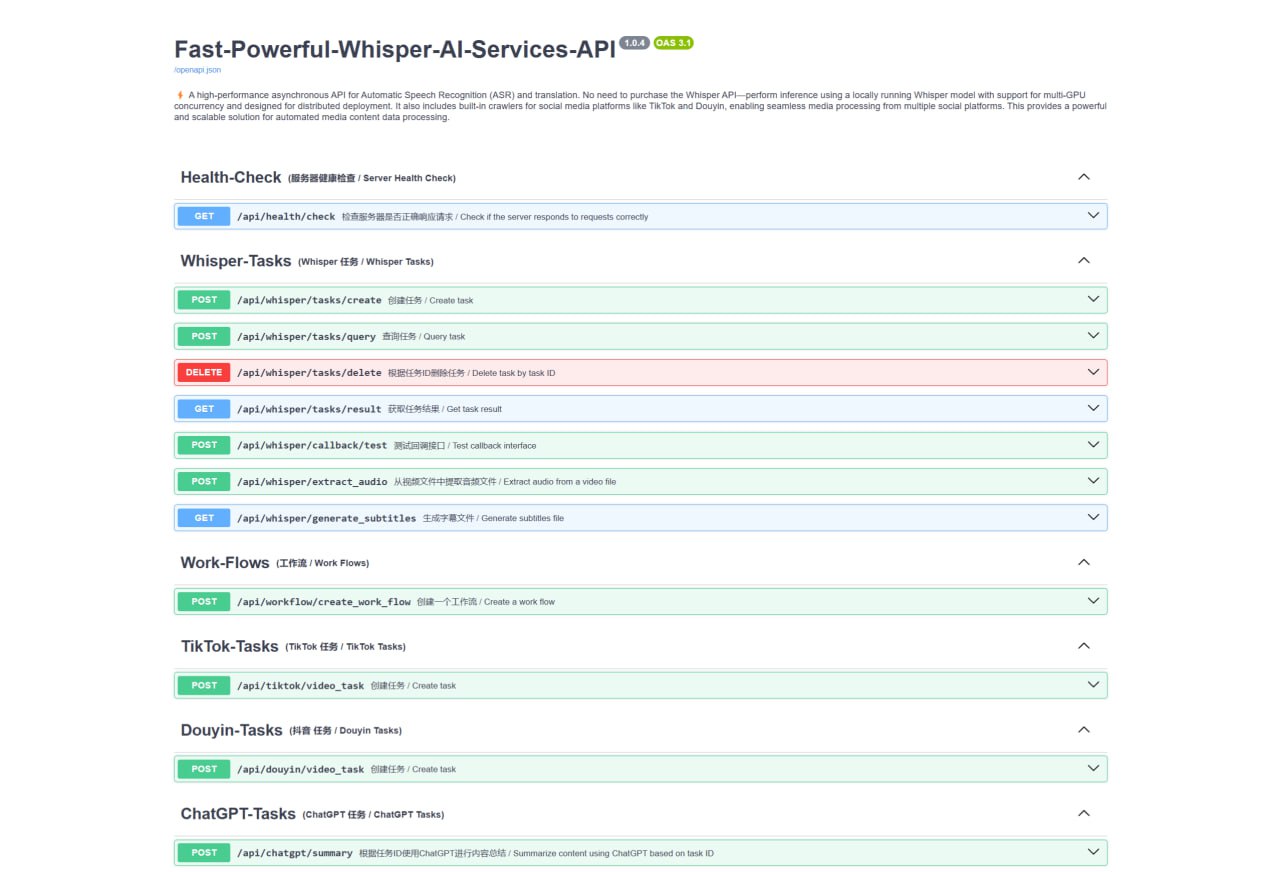
旨在构建一个强大、高性能的异步 Whisper 服务 API,支持高扩展性和分布式处理需求,适用于大规模自动语音识别场景,并集成了多平台爬虫,如抖音和 TikTok 🌟 项目特色 异步设计 :基于Python 3.11的 asyncio 异步特性,所有模块都使用异步特性进行编写,实现请求的高效处理,提升整体系统的稳定性和高并发能力。