
旨在构建一个强大、高性能的异步 Whisper 服务 API,支持高扩展性和分布式处理需求,适用
旨在构建一个强大、高性能的异步 Whisper 服务 API,支持高扩展性和分布式处理需求,适用于大规模自动语音识别场景,并集成了多平台爬虫,如抖音和 TikTok 🌟 项目特色 异步设计 :基于Python 3.11的 asyncio 异步特性,所有模块都使用异步特性进行编写,实现请求的高效处理,提升整体系统的稳定性和高并发能力。
旨在构建一个强大、高性能的异步 Whisper 服务 API,支持高扩展性和分布式处理需求,适用于大规模自动语音识别场景,并集成了多平台爬虫,如抖音和 TikTok 🌟 项目特色 异步设计 :基于Python 3.11的 asyncio 异步特性,所有模块都使用异步特性进行编写,实现请求的高效处理,提升整体系统的稳定性和高并发能力。
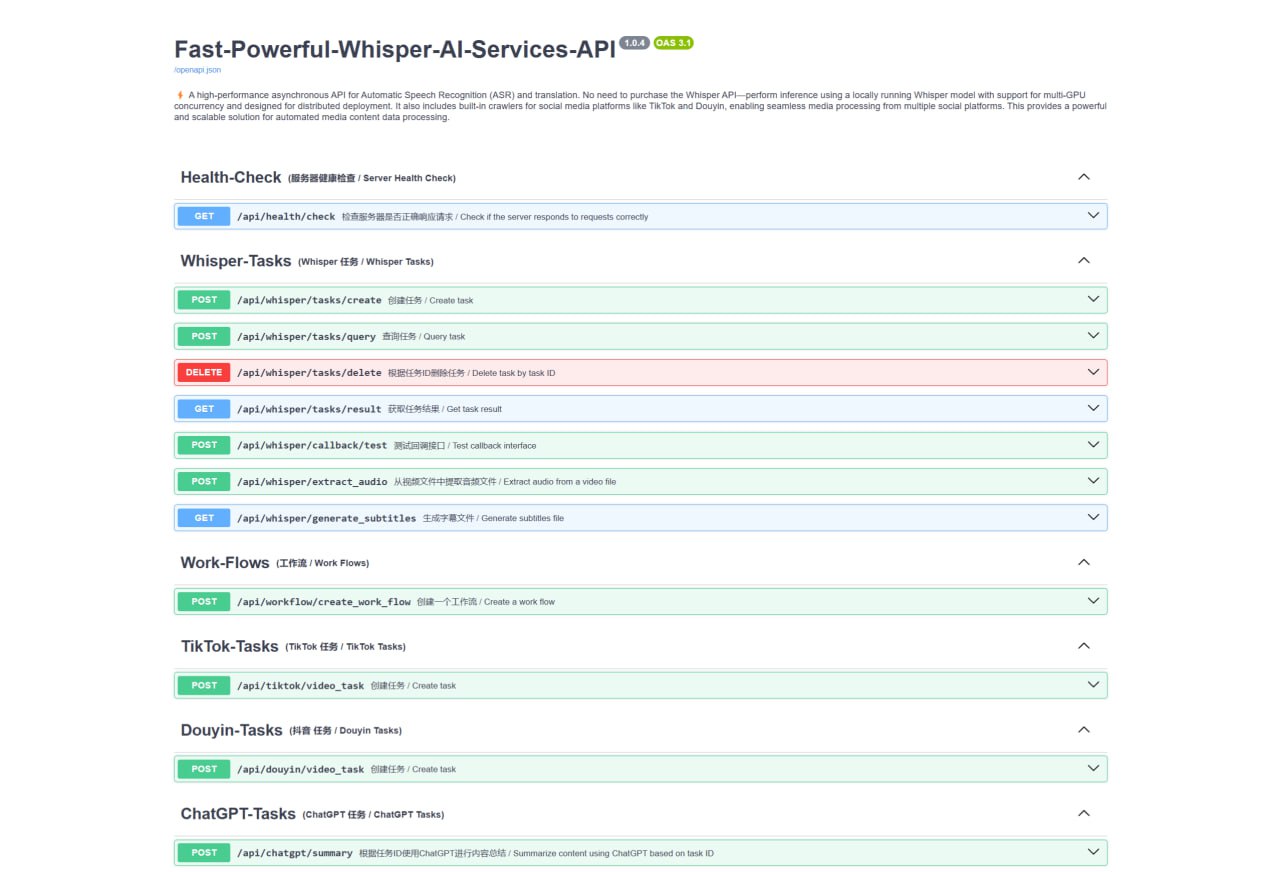
自带文档UI:得益于FastAPI自动生成的OpenAPI JSON,本项目自带一个可交互的Swagger UI用于在浏览器中可视化的测试接口,并且接口Swagger UI中带有详细的中文+英文双语说明和默认参数设置,用户可以快速的上手测试。
高准确率:使用最新的large-v3模型确保输出的准确率,并且得益于Faster Whisper的加持,在保证准确率的情况下可以极大地缩短推理所需的时间。
分布式部署:本项目可以从同一个数据库中获取任务以及存储任务结果,未来计划与Kafka无缝对接,实现FastAPI与Kafka的完美交响:构建实时更新的智能Web API 异步模型池 :本项目实现了一个高效的异步AI模型池,在线程安全的情况下支持 OpenAI Whisper 和 Faster Whisper 模型的多实例并发处理场景,在支持CUDA加速且拥有多个GPU的场景中,通过智能加载机制可以将多个模型智能的加载在多个GPU上,然后模型实例间自动分配任务,确保任务处理速度和系统负载均衡,但是在单一GPU场景下无法提供并发功能。
异步数据库:本项目支持使用MySQL和SQLite作为数据库,在本机运行时无需安装和配置MySQL,使用SQLite即可快速运行项目,如果使用MySQL则可以更好的配合分布式计算,多个节点使用同一个数据库作为任务源。
异步网络爬虫:本项目内置了多个平台的数据爬虫模块,当前支持抖音、TikTok,用户只需要输入对应的视频链接即可快速的对媒体进行语音识别,并且未来计划支持更多社交媒体平台。
ChatGPT集成:本项目已经集成了ChatGPT作为LLM部分的支持,可以使用数据库中的数据与ChatGPT进行交互。
工作流与组件化设计(待实现) :围绕 Whisper 转录任务,项目支持高度自定义的工作流系统。
用户可以通过 JSON 文件定义组件、任务依赖和执行顺序,甚至可以使用 Python 编写自定义组件,灵活扩展系统功能,轻松实现复杂的多步骤处理流程。
事件驱动的智能工作流(待实现) :工作流系统支持事件触发,可以基于时间、手动触发,或由爬虫模块自动触发。
相比单一任务,工作流更加智能,支持条件分支、任务依赖、动态参数传递和重试策略,为用户提供更高的自动化和可控性。
💫 适用场景 媒体数据处理 :适用于需要大规模语音转文本处理的场景,比如网络或本地的媒体文件转录,分析,翻译,生成字幕等应用。
自动化工作流 :虽然目前项目本身没有实现工作流,但是可以通过API于其他平台的任务流系统进行接入,通过事件驱动的工作流,轻松实现复杂任务的自动化执行,适合需要多步骤处理和条件控制的业务逻辑。
动态数据采集 :结合异步爬虫模块,系统可自动采集和处理来自网络的数据,并且存储处理完成后的数据。
利用分布算力:在多个分布的零散算力下,可以使用网关的形式将分散的算力进行有效利用。
🚩 已实现的功能: 创建任务: 支持上传媒体文件(file_upload)或指定媒体文件链接(file_url)作为任务的数据源,并且设置一系列参数更加细粒的处理任务,见下文。
设置任务类型: 用户可以通过修改(task_type)参数设置任务类型,当前支持媒体文件转文本(transcribe)或自动翻译(translate) 设置任务处理优先级: 用户可以通过 priority 参数指定任务优先级,目前支持三种优先级(high, normal, low) 任务回调通知: 用户在创建任务时可以指定 callback_url 作为任务完成后的数据接收地址,任务处理完成后会向目标地址发送一个HTTP POST请求将任务的结果数据传递到指定服务器,并且回调状态会被记录在数据库中方便审查。
多平台支持: 用户可以在对应接口中创建抖音任务、TikTok任务,也可以手动使用视频链接并且手动使用platform参数标记平台名称。
设置Whisper参数: 用户可以手动设置解码参数来修改模型的推理过程,当前支持多种参数(language,temperature, compression_ratio_threshold, no_speech_threshold, condition_on_previous_text, initial_prompt, word_timestamps, prepend_punctuations, append_punctuations, clip_timestamps, hallucination_silence_threshold) 查询任务:用户可以根据多种筛选条件查询任务列表,包括任务状态、优先级、创建时间、语言、引擎名称等信息,该接口适用于分页查询,并且通过 limit 和 offset 参数控制每页显示的记录数,支持客户端逐页加载数据。
删除任务: 用户可以根据任务ID删除任务,删除后任务数据将被永久删除。
获取任务结果:用户可以根据任务ID获取指定任务的结果信息。
提取视频的音频:运行用户上传文件来从视频文件中提取音频,支持设置采样率(sample_rate),位深度(bit_depth),输出格式(output_format)。
生成字幕文件:用户可以通过指定的任务ID来生成指定任务的字幕,并且支持指定输出格式(output_format),当前支持(srt)以及(vtt)作为字幕文件格式。
创建TikTok任务:用户可以通过 TikTok 视频链接爬取视频并创建任务。
创建抖音任务:用户可以通过抖音视频链接爬取视频并创建任务。
使用ChatGPT总结任务:用户可以使用任务ID将已经转义好的自然语言交给ChatGPT进行内容总结和其他交互,并且支持在接口选择模型和自定义提示词。
Fast-Powerful-Whisper-AI-Services-API |


