编码订阅评估应拆分模型与 Token 工作负载
编码订阅评估应拆分模型与 Token 工作负载 新公开的订阅实测方法通过隔离输入、输出、缓存写入和缓存读取,观察用量表变化,再估算不同模型与任务形态的额度。
TechFoco

共 11 篇文章,按时间倒序展示。
编码订阅评估应拆分模型与 Token 工作负载 新公开的订阅实测方法通过隔离输入、输出、缓存写入和缓存读取,观察用量表变化,再估算不同模型与任务形态的额度。
VeriHarness 用环境证据验证长程智能体结果 开源框架让同一个模型检查多个独立执行结果:对分歧追查文件、数据等证据,对一致结论也主动寻找反例,再选择或修订交付物。
🤖 DeepSeek-V4-Flash 正式版 API 上线公测 2026 年 7 月 31 日,DeepSeek 上线 V4-Flash 正式版 API 公测,Agent 能力大幅增强,基准测试成绩远超 V4-Pro-Preview。

🤖 Anthropic 发布 Claude Opus 5:性能接近 Fable 5,价格仅为其一半 Anthropic 正式推出 Claude Opus 5。

不靠工具,只靠逻辑:Gemma 4 的长程推理实验 | 帖子 通过一个复杂的维吉尼亚密码(Vigenère cipher)测试,发现 Gemma 4 在面对高难度任务时表现出极佳的“思维弹性”:它既能在被要求时进行长达十分钟的深度推理,又具备在无法解决时主动拒绝幻觉、不编造答案的诚实度。

谷歌悄悄放出数学怪兽,但你永远用不上 | 帖子 谷歌低调发布了一个叫 Aletheia 的数学专用模型,在国际数学奥林匹克竞赛基准测试上拿了满分,把所有竞争对手远远甩在身后。

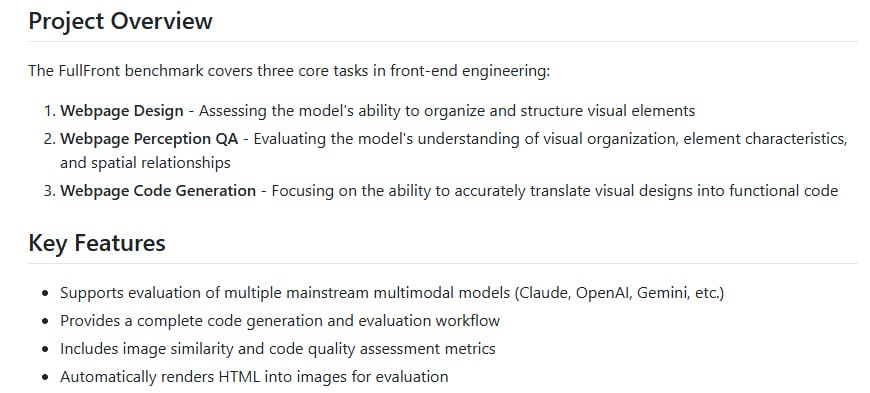
FullFront:面向多模态大语言模型(MLLM)的前端工程全流程基准测试平台,覆盖设计、理解与代码生成三大核心任务。
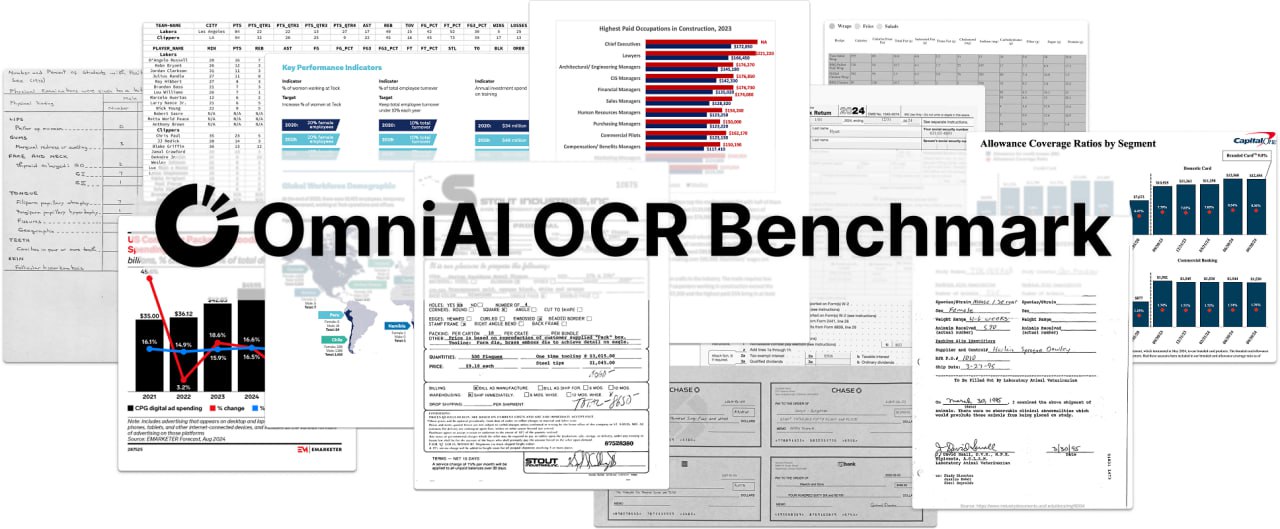
一个强大的OCR基准测试工具,帮助你快速评估不同多模态模型的OCR和数据提取能力,轻松找到最适合你的模型。