TechFoco Logo
首页专题归档站点地图
© 2026 TechFoco. All rights reserved.
文章归档专题网站地图站点地图 XML爬虫规则
  1. 首页
  2. /
  3. 返回归档
  4. /
  5. 在线自动化脚本开发常常需要复杂的浏览器控制,管理多个并行任务更是难上加难

在线自动化脚本开发常常需要复杂的浏览器控制,管理多个并行任务更是难上加难

2026年03月06日•TechFoco 精选

在线自动化脚本开发常常需要复杂的浏览器控制,管理多个并行任务更是难上加难。

在线自动化脚本开发常常需要复杂的浏览器控制,管理多个并行任务更是难上加难。

开源项目 PinchTab是一款高性能浏览器自动化桥接及多实例调度工具,支持先进的隐身注入和实时仪表盘。

它提供了统一的 HTTP 服务接口,让 AI 代理或开发者直接控制 Chrome 浏览器,支持无头和有界面模式,可以并行运行多个隔离浏览器实例,且内存占用低,token利用率高(单页提取约800 tokens,远优于截图方式)。

文章配图 1
文章配图 1

主要功能: - 命令行与 HTTP API 双重控制方式; - 多实例多用户会话隔离,支持持久化浏览器配置文件; - 高度隐身的自动化,减少被检测风险; - 支持 ARM64 架构,完美兼容树莓派等设备; - 快速集成,单个12MB二进制包,无外部依赖; - 详尽文档支持,轻松上手。

适合构建智能爬虫、自动化测试和 AI 智能助理等项目,极大提升效率与稳定性。

快速安装 curl -fsSL | bash

文章链接

  • 查看原文https://github.com/pinchtab/pinchtab

相关标签

Browser AutomationWeb ScrapingChrome DevTools ProtocolHTTP API多实例调度

继续阅读

较新文章

在线使用 AI Agent 经常遇到一个难题——让它读懂推特、Reddit、YouTube、小红

较早文章

创业墓地:这里收录了1500+个失败的创业项目,累计烧掉的资金高达4500亿美元

相关文章

查看更多
在线数据爬取工具常常需要手动应对网页结构变化和反爬措施,流程繁杂且效率低

在线数据爬取工具常常需要手动应对网页结构变化和反爬措施,流程繁杂且效率低

在线数据爬取工具常常需要手动应对网页结构变化和反爬措施,流程繁杂且效率低。

2026年03月19日
PythonWeb Scraping
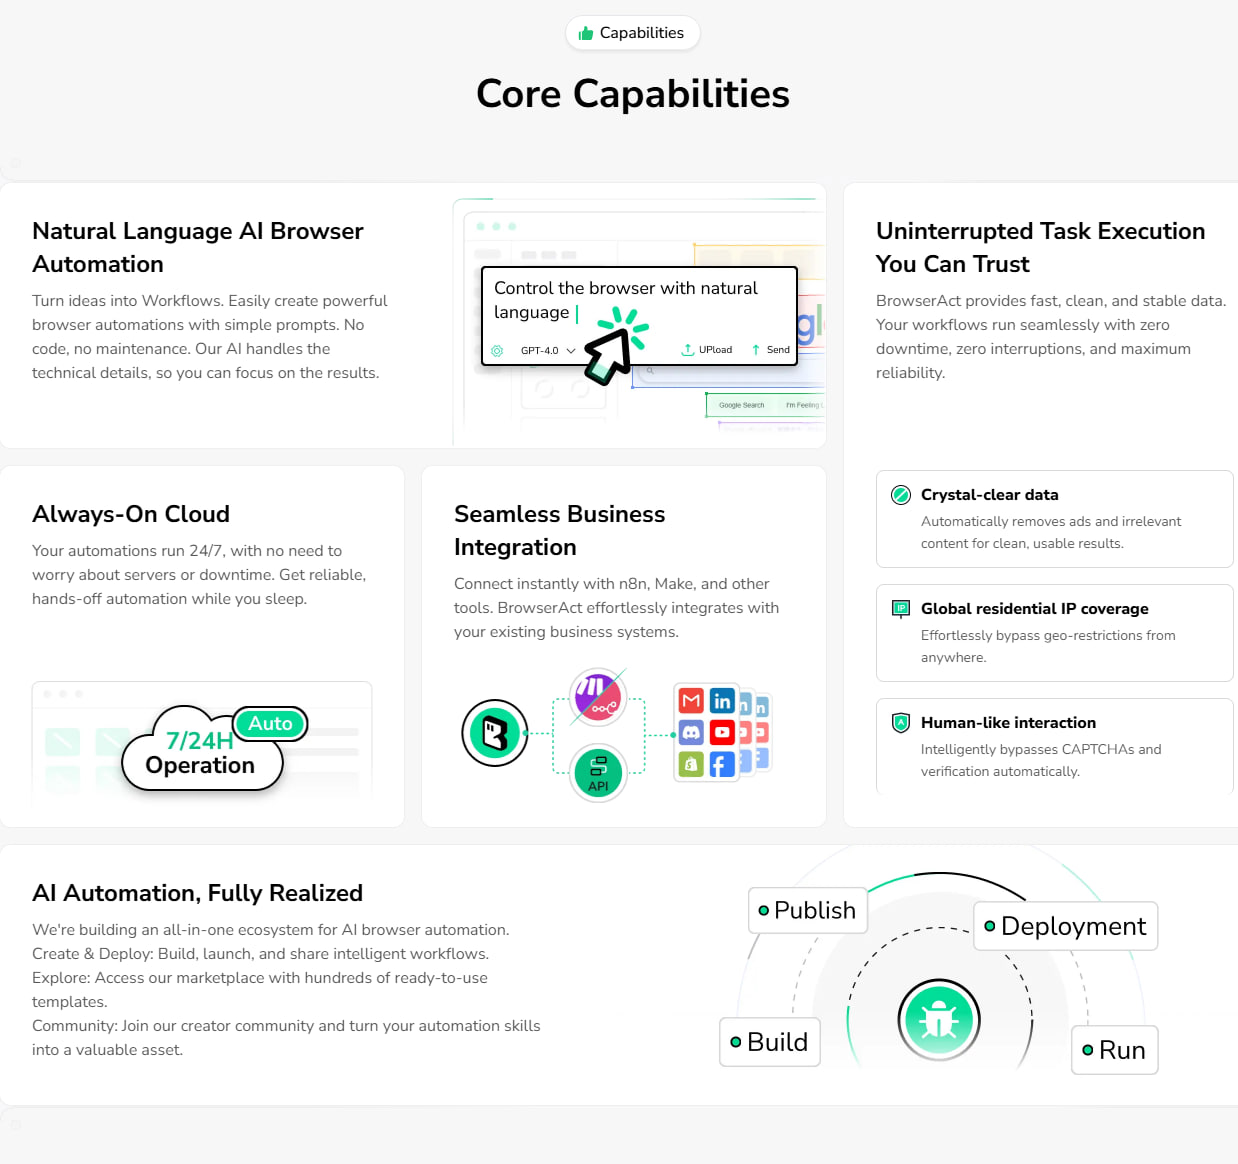
在线自动化操作网页,总得切换浏览器和脚本,流程繁琐又低效

在线自动化操作网页,总得切换浏览器和脚本,流程繁琐又低效

在线自动化操作网页,总得切换浏览器和脚本,流程繁琐又低效。

2026年03月06日
Browser AutomationAI Agent
在线使用 AI Agent 经常遇到一个难题——让它读懂推特、Reddit、YouTube、小红

在线使用 AI Agent 经常遇到一个难题——让它读懂推特、Reddit、YouTube、小红

在线使用 AI Agent 经常遇到一个难题——让它读懂推特、Reddit、YouTube、小红书等网络内容,不得不面对付费 API、封锁、登录、数据清洗一大堆麻烦。

2026年03月06日
AI AgentWeb Scraping
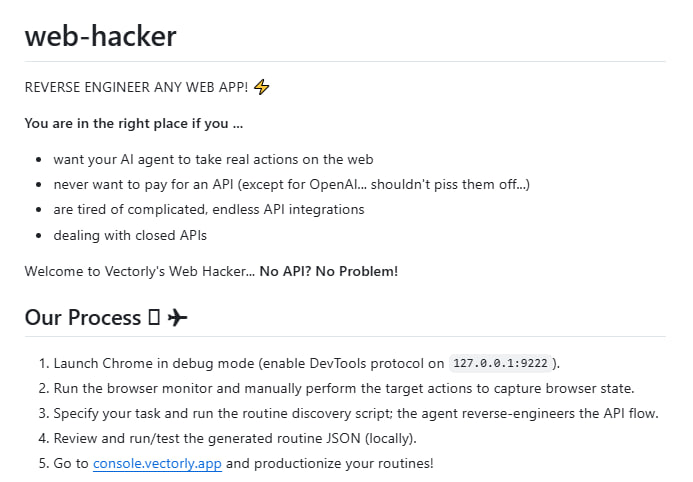
为 AI 智能体集成网页操作能力时,经常会遇到目标网站没有公开 API、接口文档极其复杂或者调用

为 AI 智能体集成网页操作能力时,经常会遇到目标网站没有公开 API、接口文档极其复杂或者调用

为 AI 智能体集成网页操作能力时,经常会遇到目标网站没有公开 API、接口文档极其复杂或者调用成本过高的问题,手动编写爬虫或自动化脚本往往费时费力。

2025年12月27日
Web ScrapingWeb Automation
自动生成基于 Playwright 的网页爬虫,从此不再为重复抓取任务写代码烦恼

自动生成基于 Playwright 的网页爬虫,从此不再为重复抓取任务写代码烦恼

自动生成基于 Playwright 的网页爬虫,从此不再为重复抓取任务写代码烦恼。

2025年11月05日
爬虫Playwright
AI Web Scraper:打破传统爬虫瓶颈,实现无代码、零限制的数据自动抓取与流程自动化

AI Web Scraper:打破传统爬虫瓶颈,实现无代码、零限制的数据自动抓取与流程自动化

AI Web Scraper:打破传统爬虫瓶颈,实现无代码、零限制的数据自动抓取与流程自动化。

2025年09月19日
Web ScrapingNo-Code Automation