Web Scraping 专题
共 11 篇文章,按时间倒序展示。

在线使用 AI Agent 经常遇到一个难题——让它读懂推特、Reddit、YouTube、小红
在线使用 AI Agent 经常遇到一个难题——让它读懂推特、Reddit、YouTube、小红书等网络内容,不得不面对付费 API、封锁、登录、数据清洗一大堆麻烦。
TechFoco


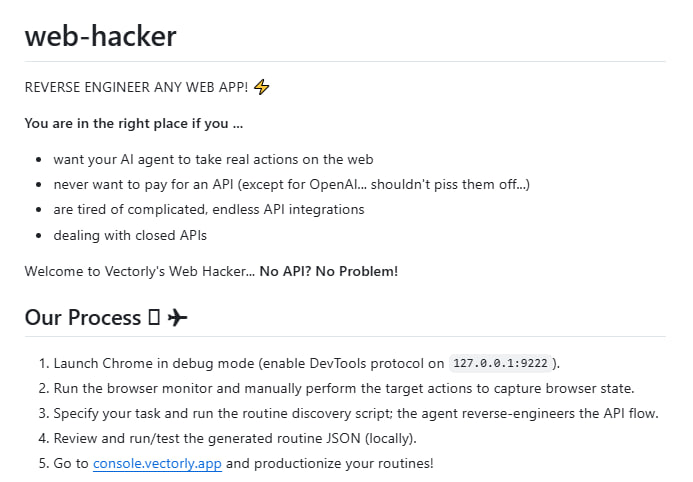
为 AI 智能体集成网页操作能力时,经常会遇到目标网站没有公开 API、接口文档极其复杂或者调用
为 AI 智能体集成网页操作能力时,经常会遇到目标网站没有公开 API、接口文档极其复杂或者调用成本过高的问题,手动编写爬虫或自动化脚本往往费时费力。
TechFoco
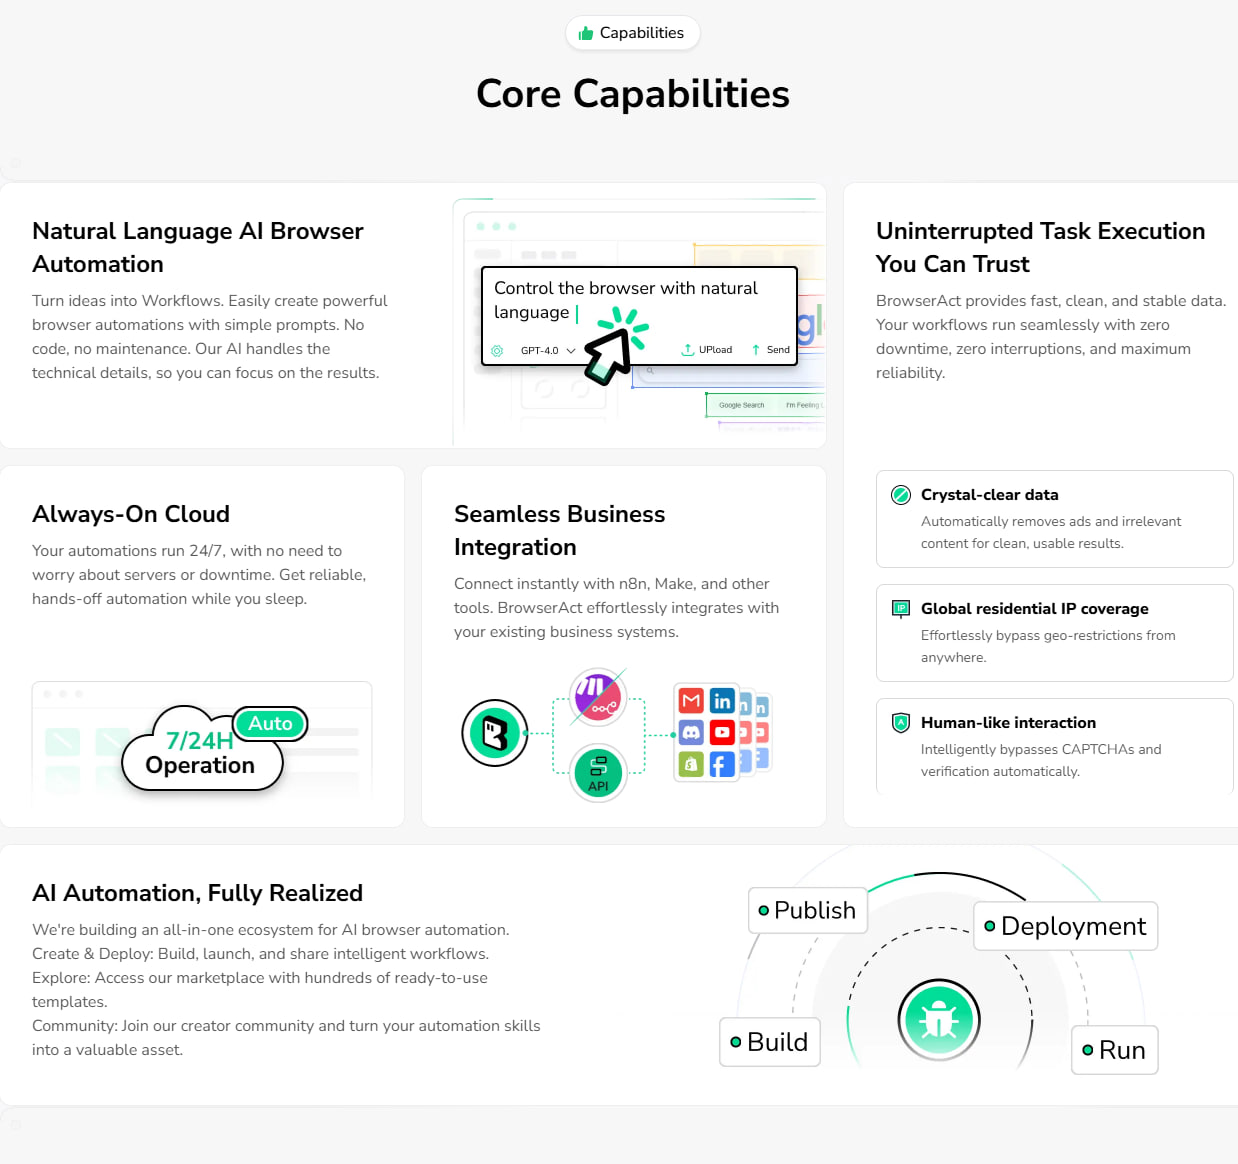
AI Web Scraper:打破传统爬虫瓶颈,实现无代码、零限制的数据自动抓取与流程自动化
AI Web Scraper:打破传统爬虫瓶颈,实现无代码、零限制的数据自动抓取与流程自动化。
TechFoco
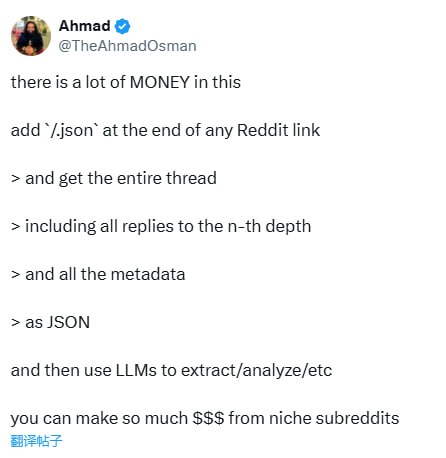
Reddit 链接加上 `/.json`,即可无需登录自动抓取完整讨论串及所有回复,直接获取深度
Reddit 链接加上 `/.json`,即可无需登录自动抓取完整讨论串及所有回复,直接获取深度嵌套的原始数据和元信息,配合 LLM 深度分析,挖掘细分社区的巨大商业价值。
TechFoco
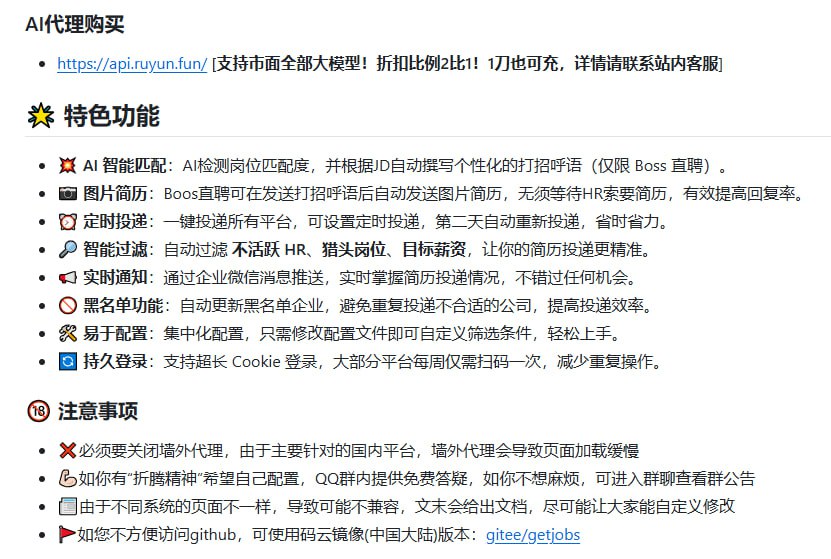
Get Jobs【工作无忧】 :覆盖主流招聘平台的自动投递利器,助力程序员精准高效求职: • 支
Get Jobs【工作无忧】 :覆盖主流招聘平台的自动投递利器,助力程序员精准高效求职: • 支持Boss、前程无忧、猎聘、拉勾、智联招聘五大平台,自动投递简历,省时省力 • AI智能匹配岗位,自动生成个性化打招呼语(Boss专属),提升HR回复率📈 • 支持Boss直聘发送图片简历,主动出击无需等待HR索要,显著增加曝光率📷 • 定时投递功能,自动重复投递,保障每天高频覆盖,不错过任何机会⏰ • 智能过滤不活跃HR、猎头岗位及不符合期望薪资岗位,精准投递,减少无效劳动 • 企业微信实时推送投递进度,动态掌控应聘情况,及时调整策略 • 自动维护黑名单,避免重复投递低效企业,优化投递质量和效率 • 配置灵活,集中管理筛选条件,支持超长Cookie登录,减少重复扫码操作 • 开源免费,欢迎参与贡献,加入开发组享免费Intelli编辑器全家桶资源 • 适合在复杂招聘环境中主动出击的求职者,推荐配合手机App使用Boss投递,避免封号风险
TechFoco
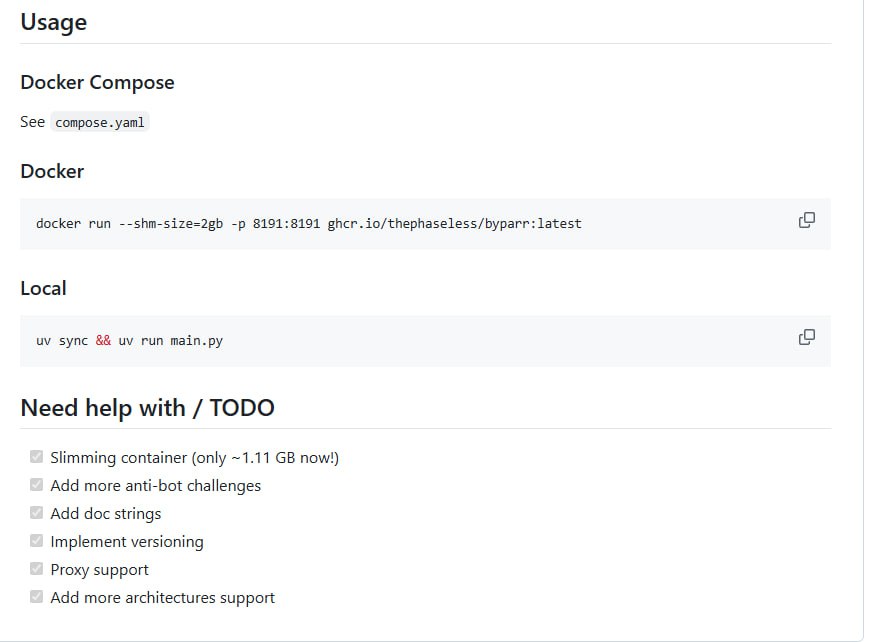
Byparr:专为绕过 Cloudflare 等反爬机制设计的 HTTP Cookie 和 He
Byparr:专为绕过 Cloudflare 等反爬机制设计的 HTTP Cookie 和 Headers 生成工具,基于 seleniumbase 与 FastAPI,接口兼容 FlareSolverr。
TechFoco
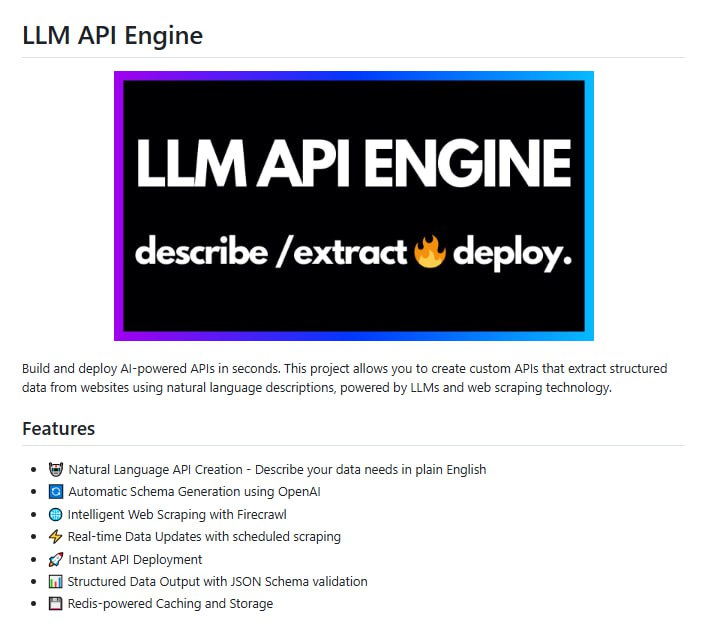
LLM API Engine:用自然语言描述就能快速生成和部署AI驱动的API 只需几秒即可创建
LLM API Engine:用自然语言描述就能快速生成和部署AI驱动的API 只需几秒即可创建API;利用LLM和网络爬虫技术,自动从网站提取结构化数据;支持多种部署方式,包括Vercel、AWS Lambda等
TechFoco