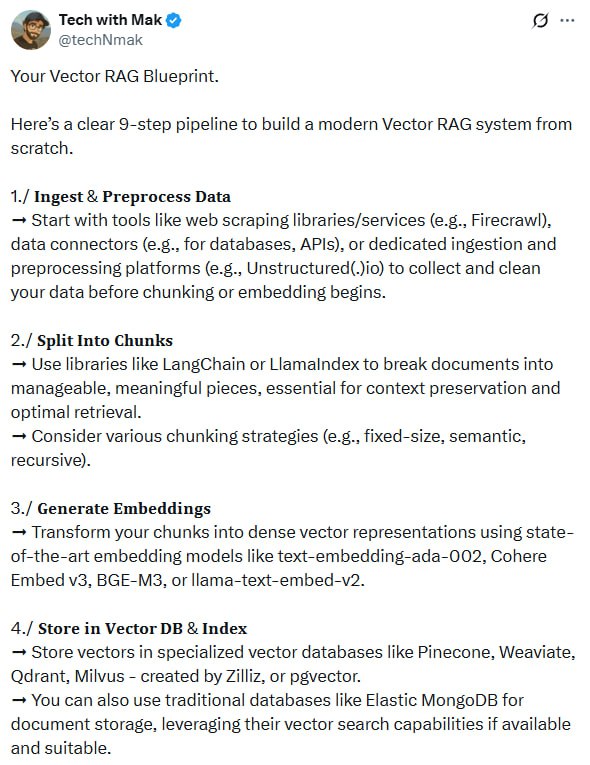
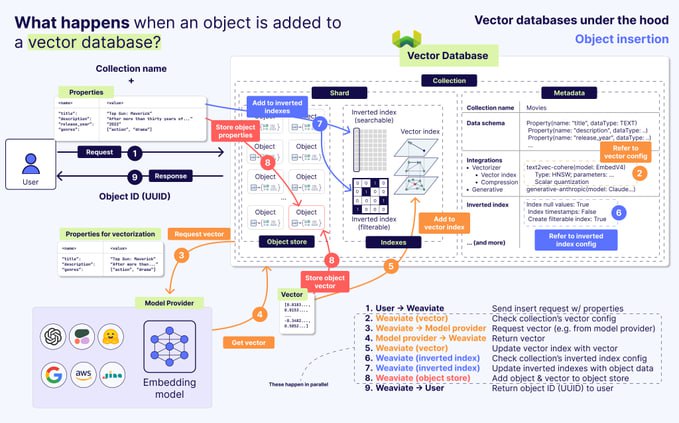
Vector RAG系统构建流程 1. 数据采集与预处理 用爬虫(如Firecrawl)、数据连
Vector RAG系统构建流程 1. 数据采集与预处理 用爬虫(如Firecrawl)、数据连接器(数据库、API)或专门的平台(如Unstructured.io)收集并清洗数据,确保后续切片和向量化质量。
TechFoco

第 48 页,共 72 页
Vector RAG系统构建流程 1. 数据采集与预处理 用爬虫(如Firecrawl)、数据连接器(数据库、API)或专门的平台(如Unstructured.io)收集并清洗数据,确保后续切片和向量化质量。
Claude Skills、Subagents 与 Projects 的职责边界 更正(2026-10-12):这三者不是固定的三层组合关系。
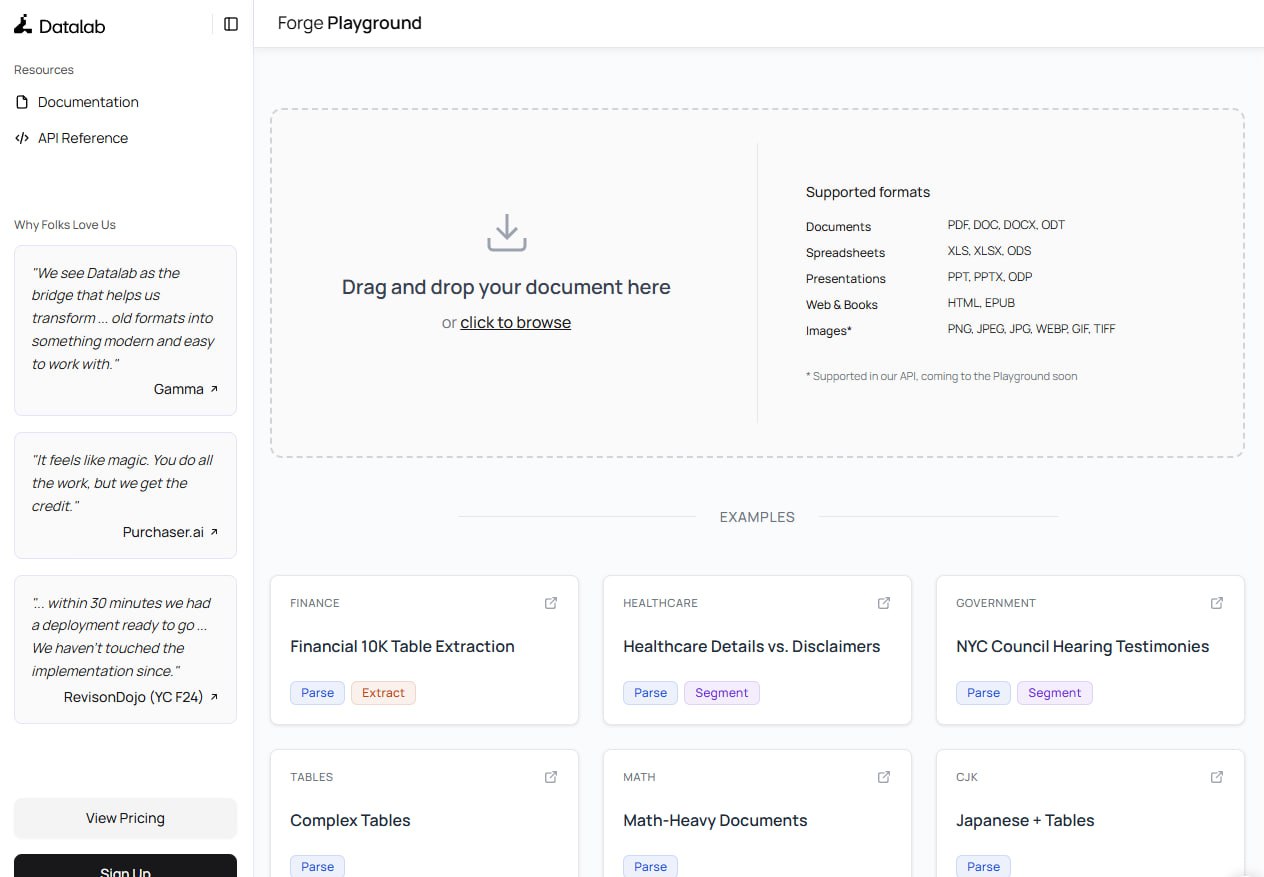
Chandra OCR开源发布,具备强大功能和广泛应用潜力: - 支持完整版面信息解析,能识别并标注图片、图表 - 优秀的手写体、表格和表单识别能力 - 兼容transformers和vLLM架构,易于集成和扩展 获取方式: Huggingface仓库 | Github代码库 | 在线演示体验(推荐平衡模式) 通过Datalab API调用,支持balanced和accurate两种模式 快速上手: pip install chandra-ocr chandra_vllm chandra input.pdf ./output 性能与对比: - 在olmocr基准测试中优于Deepseek OCR,展现出更高准确率 - 相较Marker OCR,Chandra更擅长复杂格式和整体排版,但速度稍慢 - 支持多语言(基于Surya语言支持),但对部分低资源语言仍有提升空间 已知限制: - 纯数学公式识别尚不及Marker - 旋转页面识别准确度下降 - 部分低资源语言效果欠佳 未来计划: - 持续优化模型精度和性能 - 量化与加速支持,提升推理速度 - 扩展语言和用例覆盖
开源OCR模型运行成本低且注重隐私保护,但市面上新模型层出不穷,如DeepSeek-OCR、Nanonets、PaddleOCR,选哪个成了难题。
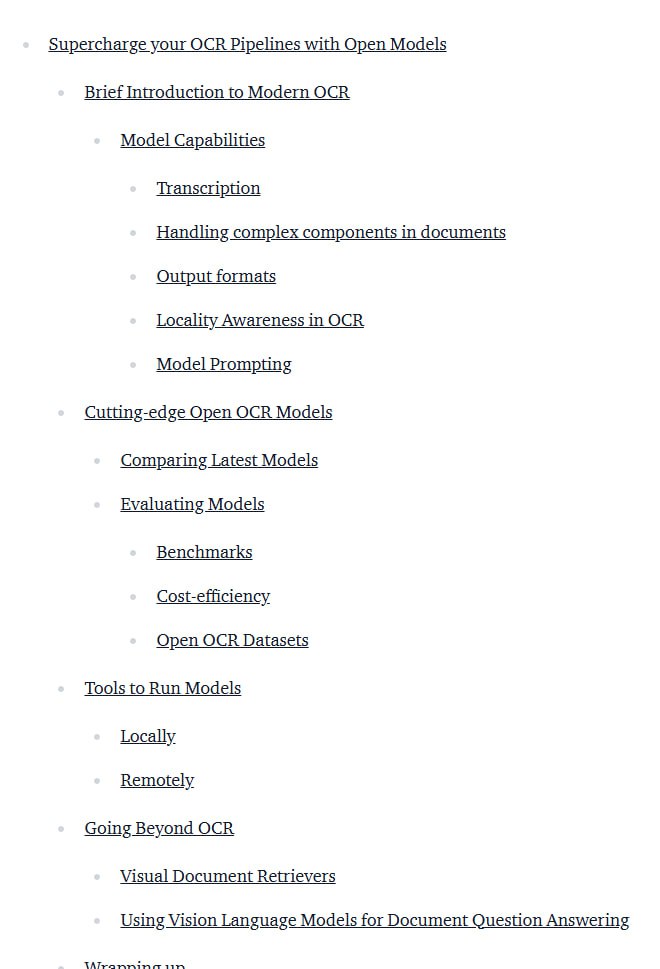
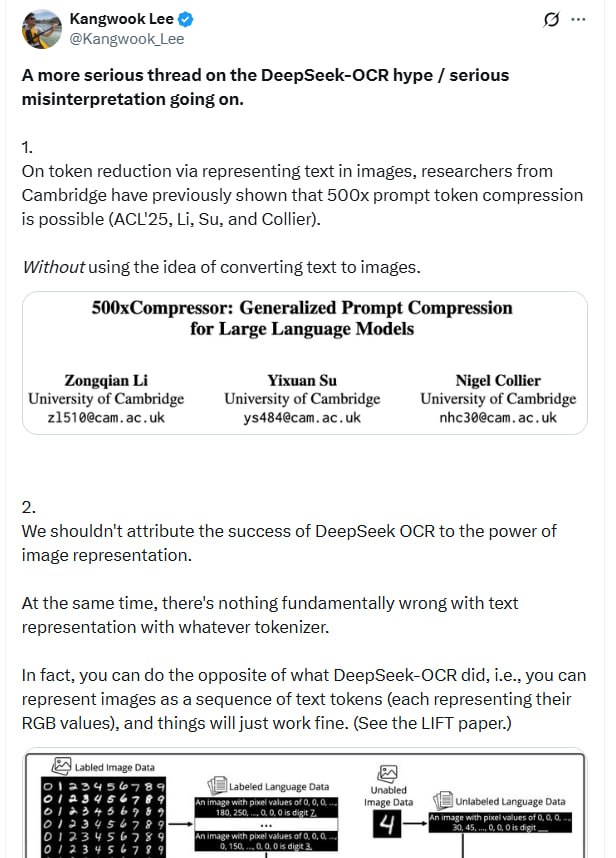
开源OCR模型运行成本低且注重隐私保护,但市面上新模型层出不穷,如DeepSeek-OCR、Nanonets、PaddleOCR,选哪个成了难题。
关于通往AGI之路,三位AI巨擘提出了截然不同的核心理念,引发了一场深刻的思考:| 原文 🤖 三巨头的路线之争: 1、 Yann LeCun (CNN之父):世界模型 + 感知。
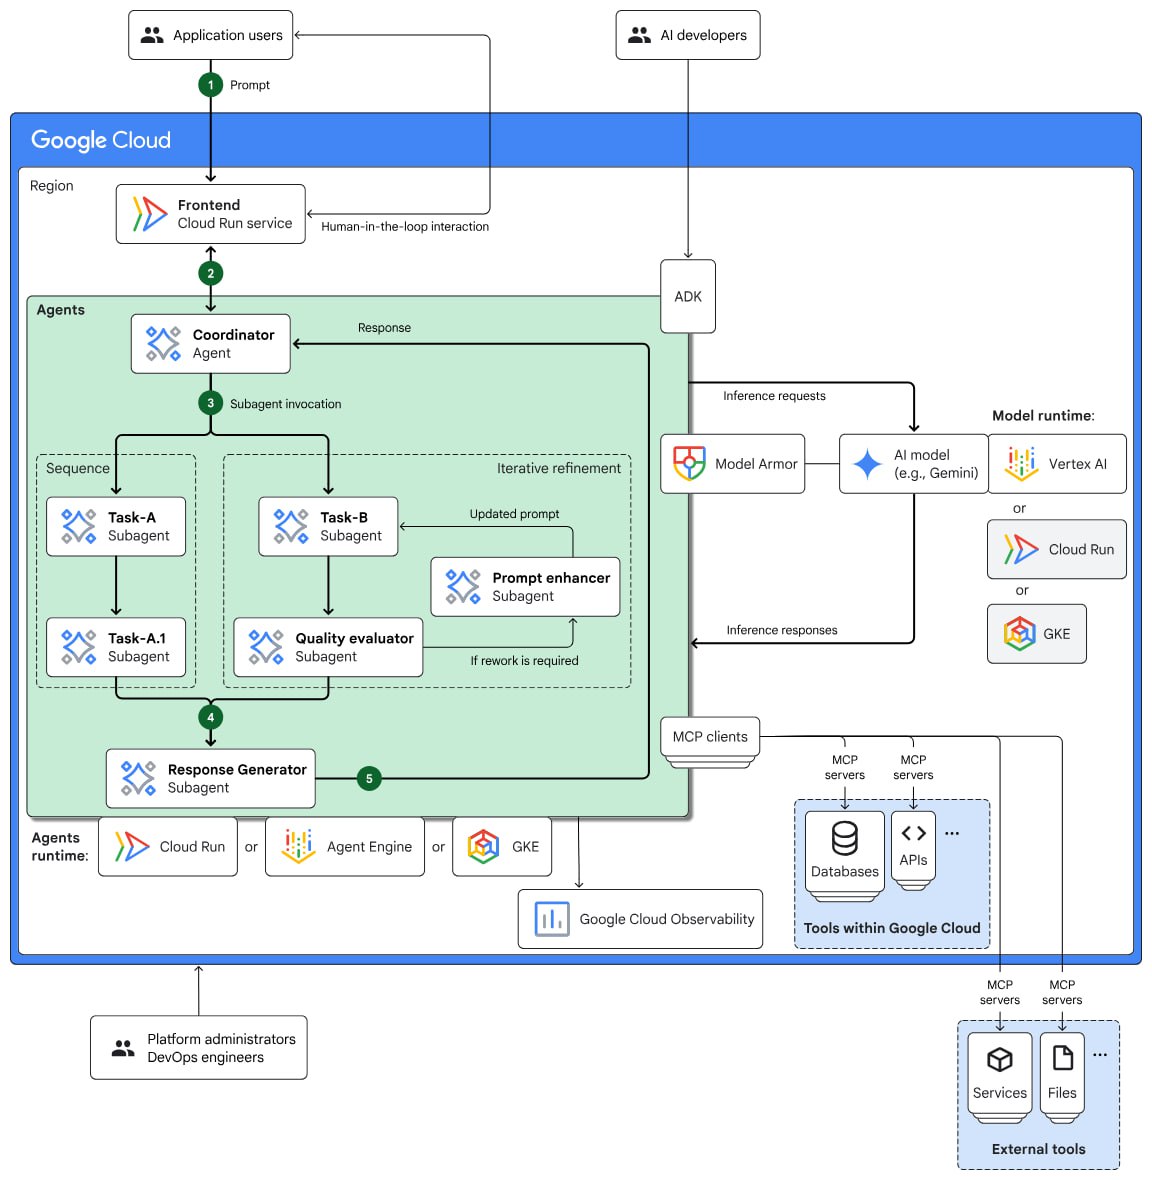
Google Cloud 推出多智能体 AI 系统参考架构,助力构建高效协作的专业 AI 代理,实现复杂业务流程优化。
how to read research papers, in 5 minutes. | 很多人没被教过如何高效阅读研究论文。

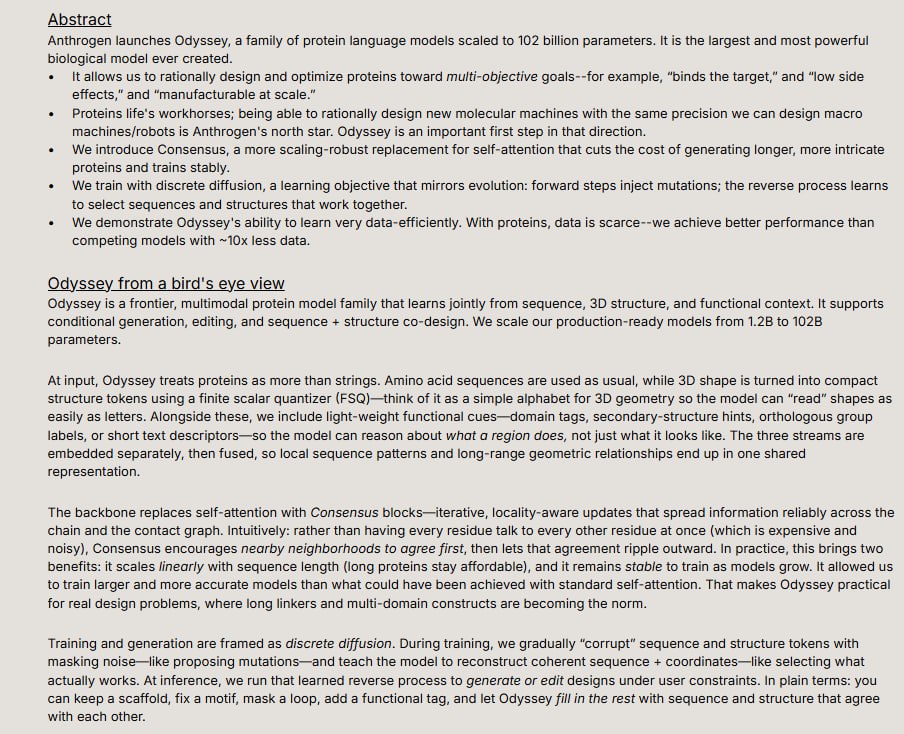
Anthrogen团队推出了Odyssey——迄今为止最大、性能最强的蛋白质语言模型,参数规模超过1020亿。

开发者日常配置、监控Anthropic Claude Code再也不用手动写一堆脚本了 Claude Code Templates 是一个开源CLI工具,提供了丰富的预设配置和插件集,帮你快速搭建和管理AI开发环境。

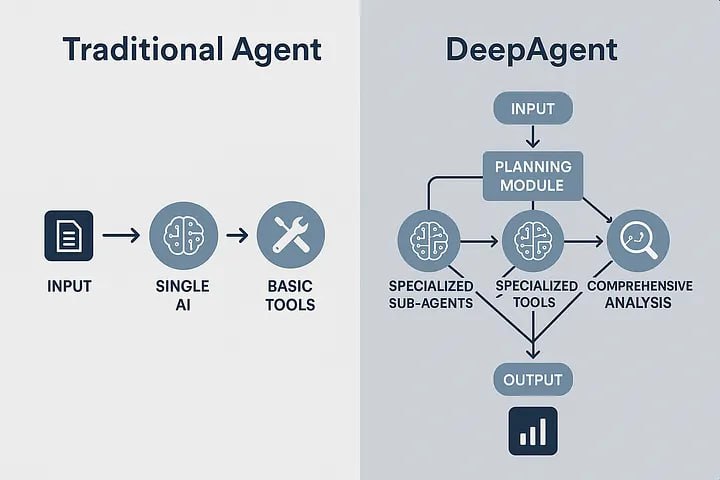
用LangChain DeepAgents搭建的一个媲美Claude分析工具的智能股票研究Agent,帮你系统化、多维度做专业级股市分析。
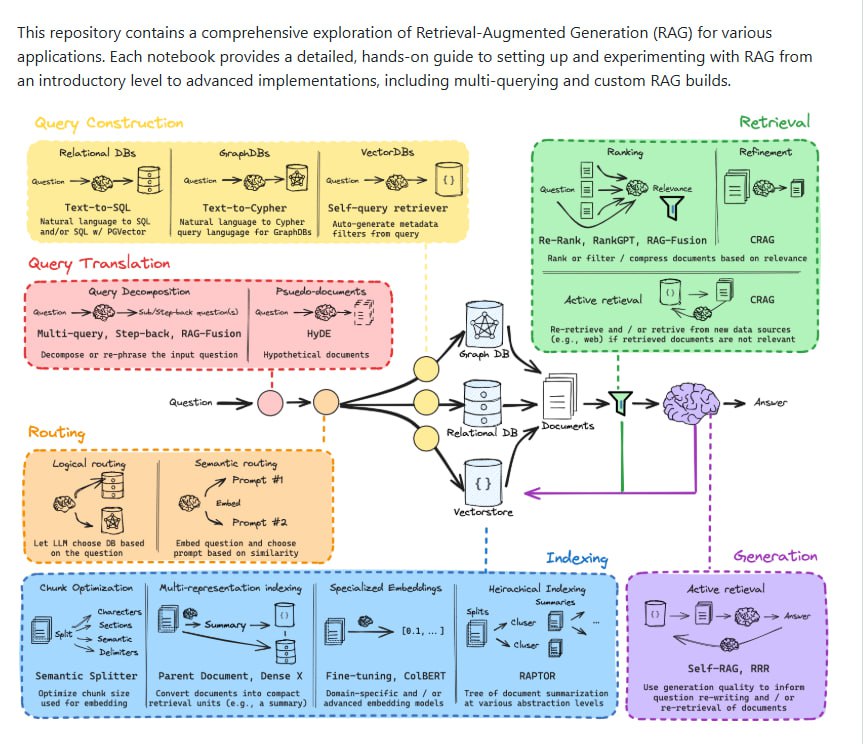
Retrieval-Augmented Generation (RAG) Project:这份开源资源帮你从零开始全面掌握RAG(检索增强生成)技术,实用且系统。