TechFoco Logo
首页专题归档站点地图
© 2026 TechFoco. All rights reserved.
文章归档专题网站地图站点地图 XML爬虫规则
  1. 首页
  2. /
  3. 返回归档
  4. /
  5. 一款开源高效文档转换工具,专注将PDF及多种格式文档精准转为纯文本,同时保持自然的阅读顺序

一款开源高效文档转换工具,专注将PDF及多种格式文档精准转为纯文本,同时保持自然的阅读顺序

2025年10月29日•TechFoco 精选

一款开源高效文档转换工具,专注将PDF及多种格式文档精准转为纯文本,同时保持自然的阅读顺序。
文章配图 1
文章配图 1

文章配图 2
文章配图 2

文章配图 3
文章配图 3

一款开源高效文档转换工具,专注将PDF及多种格式文档精准转为纯文本,同时保持自然的阅读顺序。
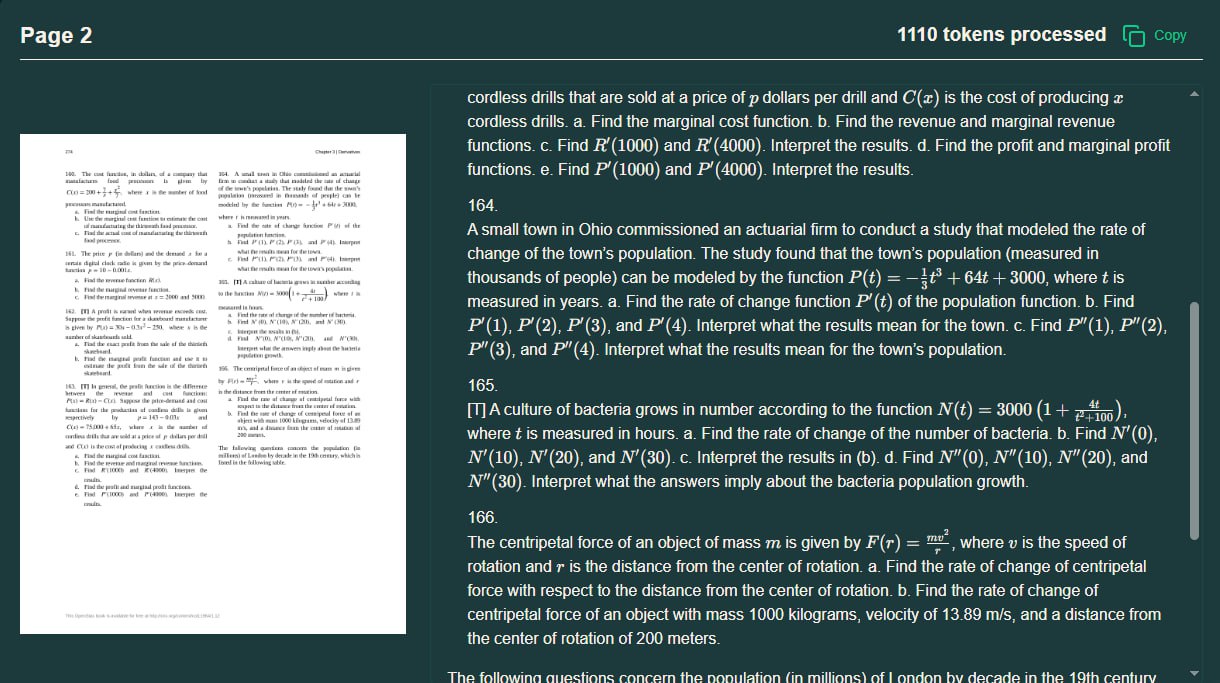
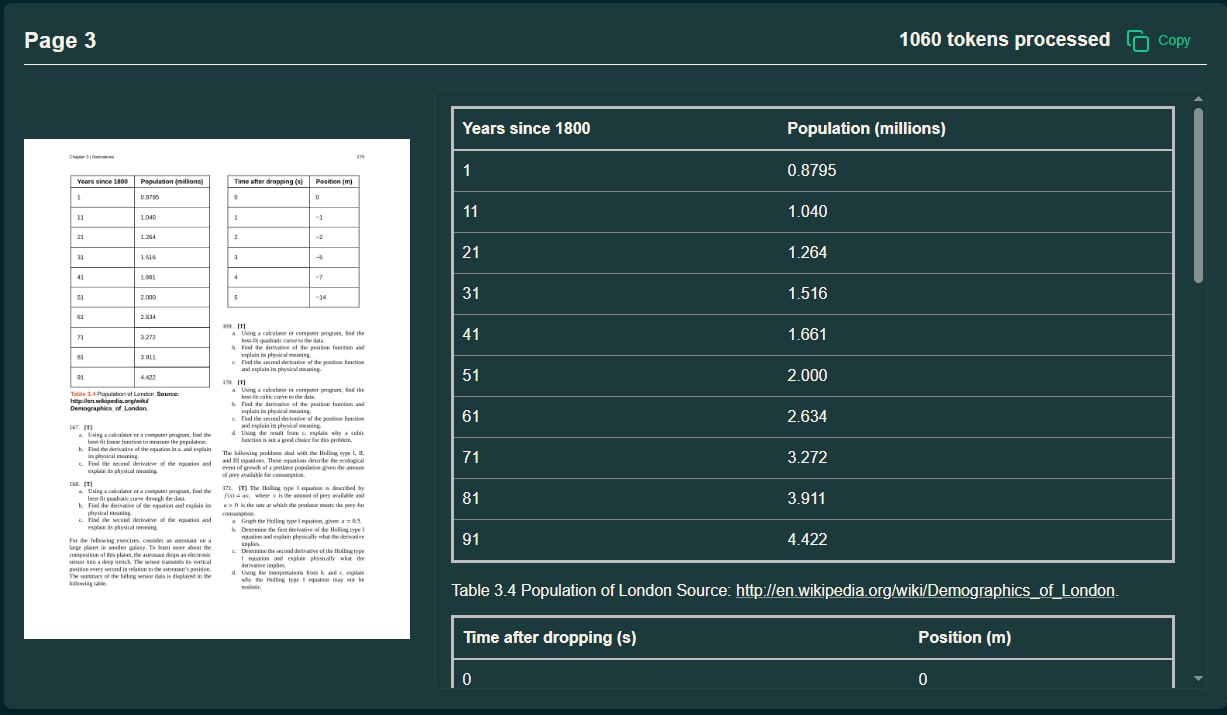
支持表格、公式、手写内容等复杂元素,适用范围广泛。

该版本基于大量精选学术论文、技术文档等高质量数据训练,结合合成数据与强化学习中的单元测试奖励机制,显著降低了“幻觉”错误,提升了识别准确率。
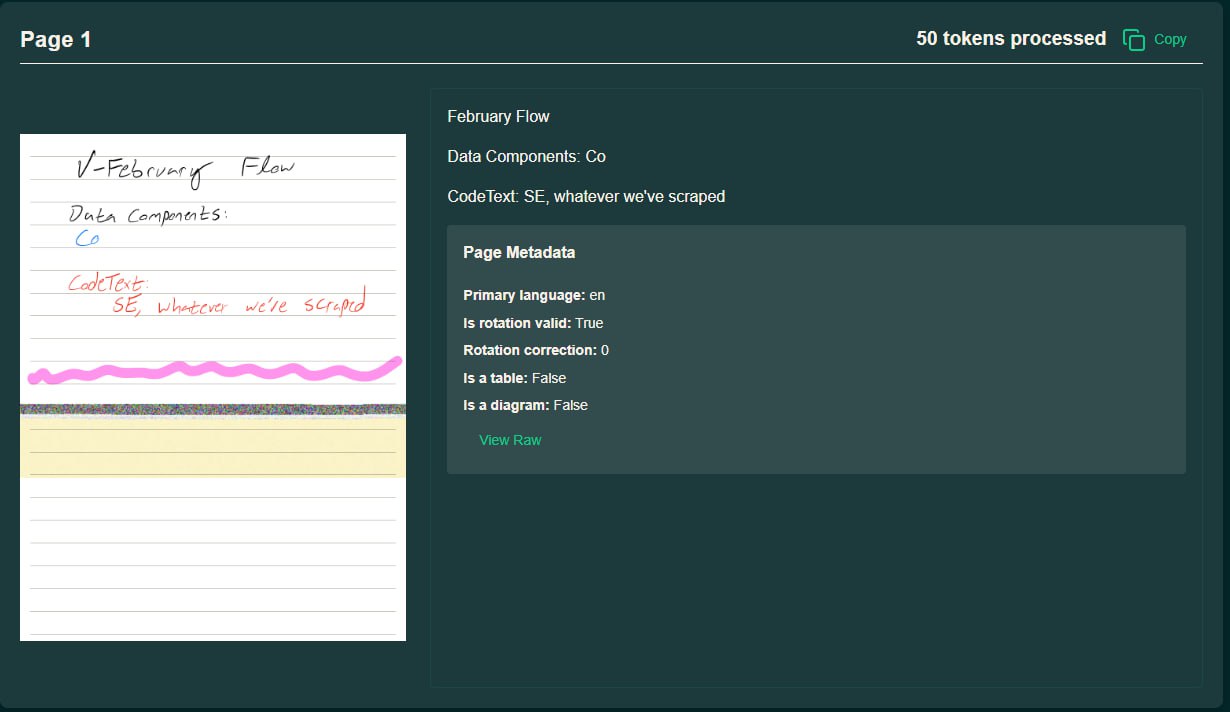
文章配图 1
文章配图 1

当前模型在多语言视觉语言模型基础上微调,主要优化英文文档,其他语言也具备一定兼容性。

用户不仅可在线体验,还能在自有GPU上部署完整工具包,实现高效、可扩展的批量文档处理,成本低廉。

文章配图 2
文章配图 2

此工具为科研、教育及档案数字化提供了强大支持,推动文档自动化处理迈向更精准智能的未来。

olmOCR 2 |

文章链接

  • 查看原文https://olmocr.allenai.org/

相关标签

OCRDocument ConversionPDF ProcessingDeep LearningMultimodal Model

继续阅读

较新文章

数据库设计和管理常常需要反复查看表结构和关系,光靠SQL语句难以直观理解,团队协作也不便

较早文章

Google Opal 提供了一个无需编程即可构建、编辑和分享 AI 小应用的平台,用户只需用自

相关文章

查看更多
Unlimited OCR 是一款专为长文本与多页文档打造的 OCR 解析引擎,将单次推理的视野

Unlimited OCR 是一款专为长文本与多页文档打造的 OCR 解析引擎,将单次推理的视野

Unlimited OCR 是一款专为长文本与多页文档打造的 OCR 解析引擎,将单次推理的视野从单页扩展到整篇文档,真正实现「一镜到底」的高精度解析。

2026年06月24日
OCR长文本
OCR识别需要多个工具,布局分析工具拆分文档结构,文本识别模型提取内容,还要额外的手动后处理,来

OCR识别需要多个工具,布局分析工具拆分文档结构,文本识别模型提取内容,还要额外的手动后处理,来

OCR识别需要多个工具,布局分析工具拆分文档结构,文本识别模型提取内容,还要额外的手动后处理,来回切换效率低下。

2026年05月11日
OCR文档理解
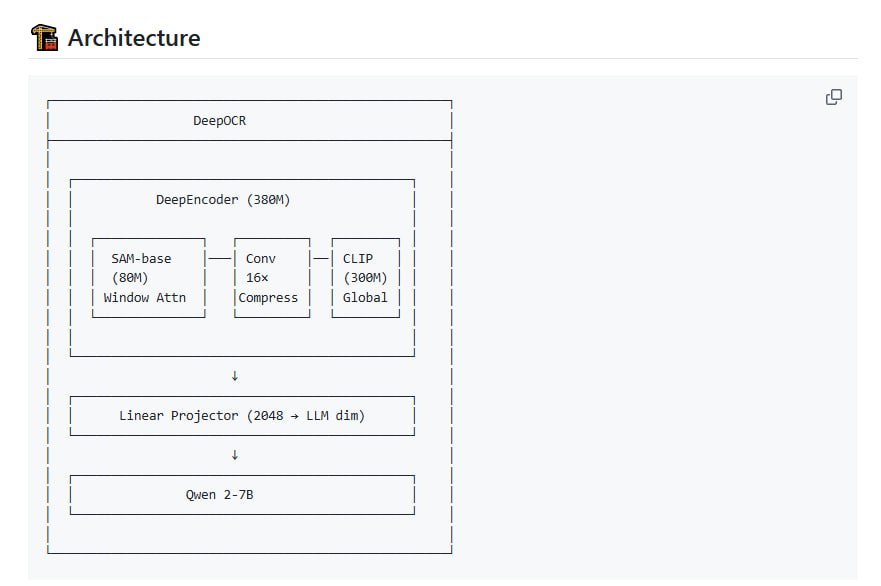
DeepOCR -- DeepSeek-OCR的完全开源复现项目 DeepSeek-OCR的开源

DeepOCR -- DeepSeek-OCR的完全开源复现项目 DeepSeek-OCR的开源

DeepOCR -- DeepSeek-OCR的完全开源复现项目 DeepSeek-OCR的开源是只包含权重和技术报告,想复现还是有些难度。

2025年11月12日
OCR计算机视觉
DeepOCR -- DeepSeek-OCR的完全开源复现项目 DeepSeek-OCR的开源

DeepOCR -- DeepSeek-OCR的完全开源复现项目 DeepSeek-OCR的开源

DeepOCR -- DeepSeek-OCR的完全开源复现项目 DeepSeek-OCR的开源是只包含权重和技术报告,想复现还是有些难度。

2025年11月09日
OCRComputer Vision
Chandra OCR开源发布,具备强大功能和广泛应用潜力: - 支持完整版面信息解析,能识别并

Chandra OCR开源发布,具备强大功能和广泛应用潜力: - 支持完整版面信息解析,能识别并

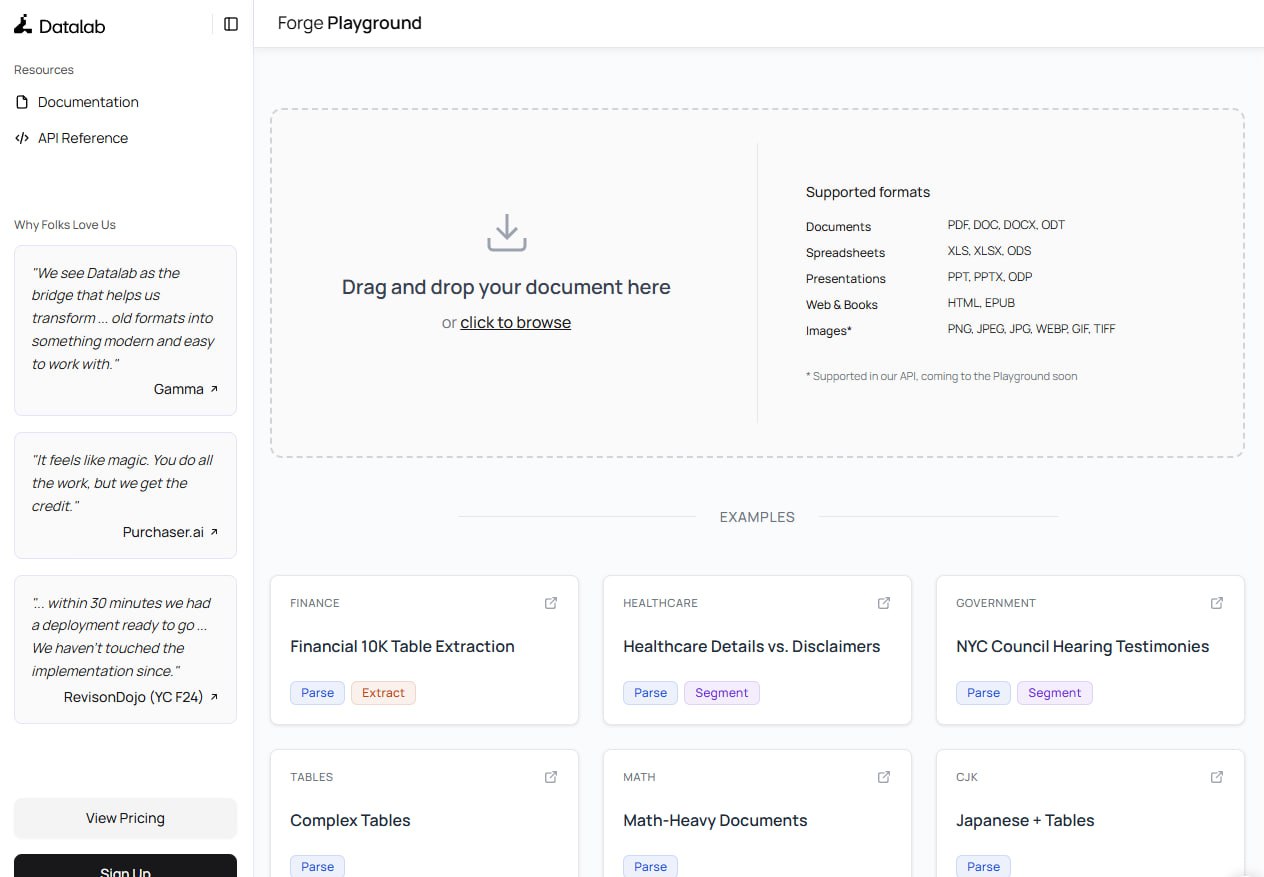
Chandra OCR开源发布,具备强大功能和广泛应用潜力: - 支持完整版面信息解析,能识别并标注图片、图表 - 优秀的手写体、表格和表单识别能力 - 兼容transformers和vLLM架构,易于集成和扩展 获取方式: Huggingface仓库 | Github代码库 | 在线演示体验(推荐平衡模式) 通过Datalab API调用,支持balanced和accurate两种模式 快速上手: pip install chandra-ocr chandra_vllm chandra input.pdf ./output 性能与对比: - 在olmocr基准测试中优于Deepseek OCR,展现出更高准确率 - 相较Marker OCR,Chandra更擅长复杂格式和整体排版,但速度稍慢 - 支持多语言(基于Surya语言支持),但对部分低资源语言仍有提升空间 已知限制: - 纯数学公式识别尚不及Marker - 旋转页面识别准确度下降 - 部分低资源语言效果欠佳 未来计划: - 持续优化模型精度和性能 - 量化与加速支持,提升推理速度 - 扩展语言和用例覆盖

2025年10月26日
OCRDocument Parsing
开源OCR模型运行成本低且注重隐私保护,但市面上新模型层出不穷,如DeepSeek-OCR、Na

开源OCR模型运行成本低且注重隐私保护,但市面上新模型层出不穷,如DeepSeek-OCR、Na

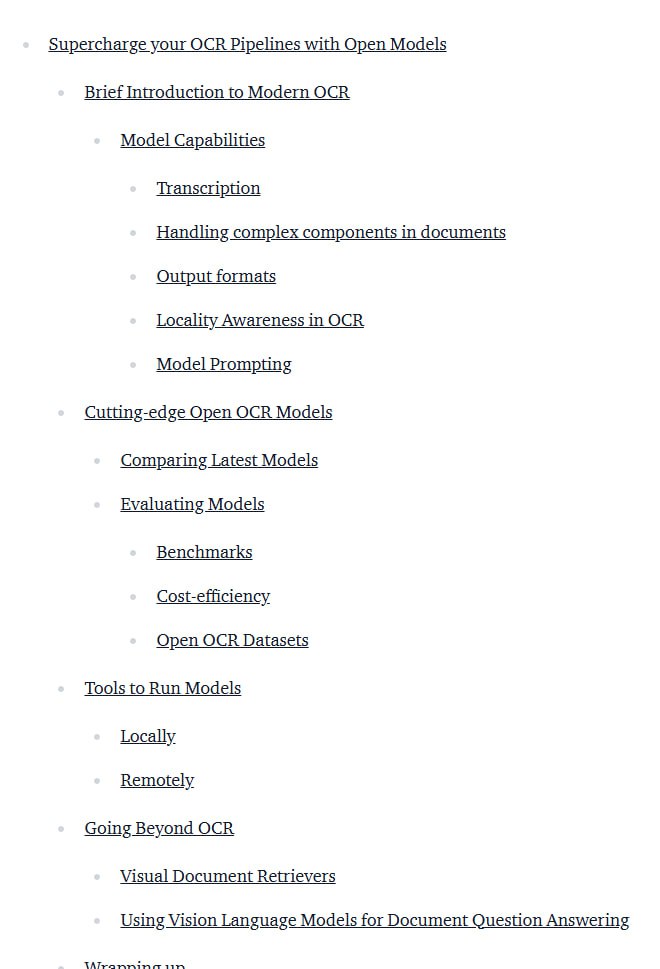
开源OCR模型运行成本低且注重隐私保护,但市面上新模型层出不穷,如DeepSeek-OCR、Nanonets、PaddleOCR,选哪个成了难题。

2025年10月26日
OCR开源模型