TechFoco Logo
首页专题归档站点地图
© 2026 TechFoco. All rights reserved.
文章归档专题网站地图站点地图 XML爬虫规则
  1. 首页
  2. /
  3. 返回归档
  4. /
  5. 深度学习为何有效?——全息原理揭秘

深度学习为何有效?——全息原理揭秘

2025年10月07日•TechFoco 精选

深度学习为何有效?

深度学习为何有效?

——全息原理揭秘 | 相关视频 🔍 深度学习的核心秘密,或许藏在“全息原理”(Holographic Principle)中。

这个概念来源于物理学,意味着高维信息可以浓缩于较低维度的结构中,而神经网络正是利用了类似的“张量网络”结构,实现对复杂数据的高效表达与处理。

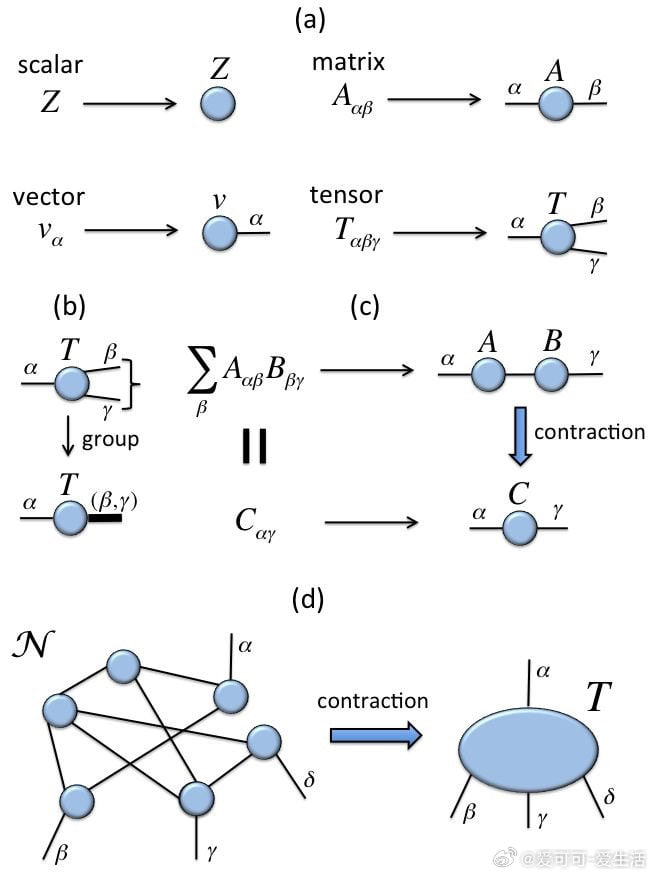
📊 图示解析: (a) 标量、向量、矩阵、张量的基本表示,揭示数据从简单到复杂的多维扩展。

(b) 张量的分组,说明如何将复杂结构拆解成更简单的部分,便于计算。

(c) 张量乘积与缩并,揭示神经网络中信息融合与特征抽取的数学本质。
文章配图 1
文章配图 1

(d) 张量网络示意,展示神经网络层间复杂连接如何通过张量缩并实现高效计算。

💡 深度学习通过张量网络将高维数据映射为紧凑结构,类似全息图将三维信息储存在二维表面。

这样的结构不仅节省了计算资源,还提升了泛化能力,解释了为何深度神经网络能在海量数据中捕捉关键特征。

🔗 这为理解深度学习的工作机制提供了新的视角:不是简单的堆叠层级,而是信息的全息编码与解码过程。

——深度学习的力量,正源于对信息结构的“全息”把握。

文章链接

  • 查看原文https://www.bilibili.com/video/av17842504/?vd_source=ab04970d330276e860b4bfbdb2565ab1

相关标签

深度学习全息原理张量网络神经网络信息编码

继续阅读

较新文章

很多实时流式数据传输场景中,网络断开导致数据丢失是个难题

较早文章

使用Claude Code、OpenAI、Gemini等大模型订阅,通常要面对多账号管理、接口不

相关文章

查看更多
Unlimited OCR 是一款专为长文本与多页文档打造的 OCR 解析引擎,将单次推理的视野

Unlimited OCR 是一款专为长文本与多页文档打造的 OCR 解析引擎,将单次推理的视野

Unlimited OCR 是一款专为长文本与多页文档打造的 OCR 解析引擎,将单次推理的视野从单页扩展到整篇文档,真正实现「一镜到底」的高精度解析。

2026年06月24日
OCR长文本
不要用“模仿大脑”来给AI计算量注水了

不要用“模仿大脑”来给AI计算量注水了

不要用“模仿大脑”来给AI计算量注水了 | 帖子 最近有研究试图用更符合生物学特征的复杂模型去迭代1950年代延续至今的经典神经元公式($u = \text{activation}(w \cdot x + b)$),声称能大幅减少训练所需的数据量。

2026年06月04日
AI神经网络
顿悟现象、隐式正则化:深度学习隐藏的底层逻辑 | paper 提要:深度学习正从工程经验向科学理

顿悟现象、隐式正则化:深度学习隐藏的底层逻辑 | paper 提要:深度学习正从工程经验向科学理

顿悟现象、隐式正则化:深度学习隐藏的底层逻辑 | paper 提要:深度学习正从工程经验向科学理论跨越。

2026年04月30日
深度学习隐式正则化
LLM的幻觉根源:不到0.1%的神经元在作祟 | 帖子 中国研究者发现,LLM中不到0.1%的特

LLM的幻觉根源:不到0.1%的神经元在作祟 | 帖子 中国研究者发现,LLM中不到0.1%的特

LLM的幻觉根源:不到0.1%的神经元在作祟 | 帖子 中国研究者发现,LLM中不到0.1%的特定神经元可以可靠预测幻觉的发生,这些神经元早在预训练阶段就已形成,并与模型的“过度顺从”行为直接相关。

2026年02月28日
LLMAI幻觉
打开AI黑盒:让大模型的内部结构肉眼可见 | 帖子 | 项目地址 | 在线体验 | 经典参考 我

打开AI黑盒:让大模型的内部结构肉眼可见 | 帖子 | 项目地址 | 在线体验 | 经典参考 我

打开AI黑盒:让大模型的内部结构肉眼可见 | 帖子 | 项目地址 | 在线体验 | 经典参考 我们每天都在使用大语言模型,但它们内部究竟长什么样?

2026年02月11日
模型可视化GGUF

50小时,从零到能训练大语言模型

50小时,从零到能训练大语言模型 | 帖子 | 这是一份经过验证的机器学习工程师养成指南。

2026年01月23日
机器学习深度学习